Windows-Desktop-Programm

Der vollständigste Weg, Leistung und Fähigkeiten lokaler LLMs zu messen

GpuLLM ist eine kostenlose Windows-Anwendung, mit der du lokale Sprachmodelle umfassend bewertest – sowohl die Inferenzgeschwindigkeit (Tokens/s, Latenz) als auch die Modellfähigkeiten (MMLU, C-Eval-Trefferquote). Alles läuft zu 100 % offline – Chat, Benchmark, GPU-Überwachung, Modellverwaltung; das Einzige, das das Internet berührt, ist der Modell-Download. Finde in Minuten statt Stunden die passende Kombination aus Modell und Hardware. Keine Cloud-Abhängigkeit, keine API-Schlüssel, keine Daten verlassen deinen Rechner.

Windows 10 / 11100% Offline11 LanguagesCUDA / Vulkan / CPU

Überzeuge dich selbst

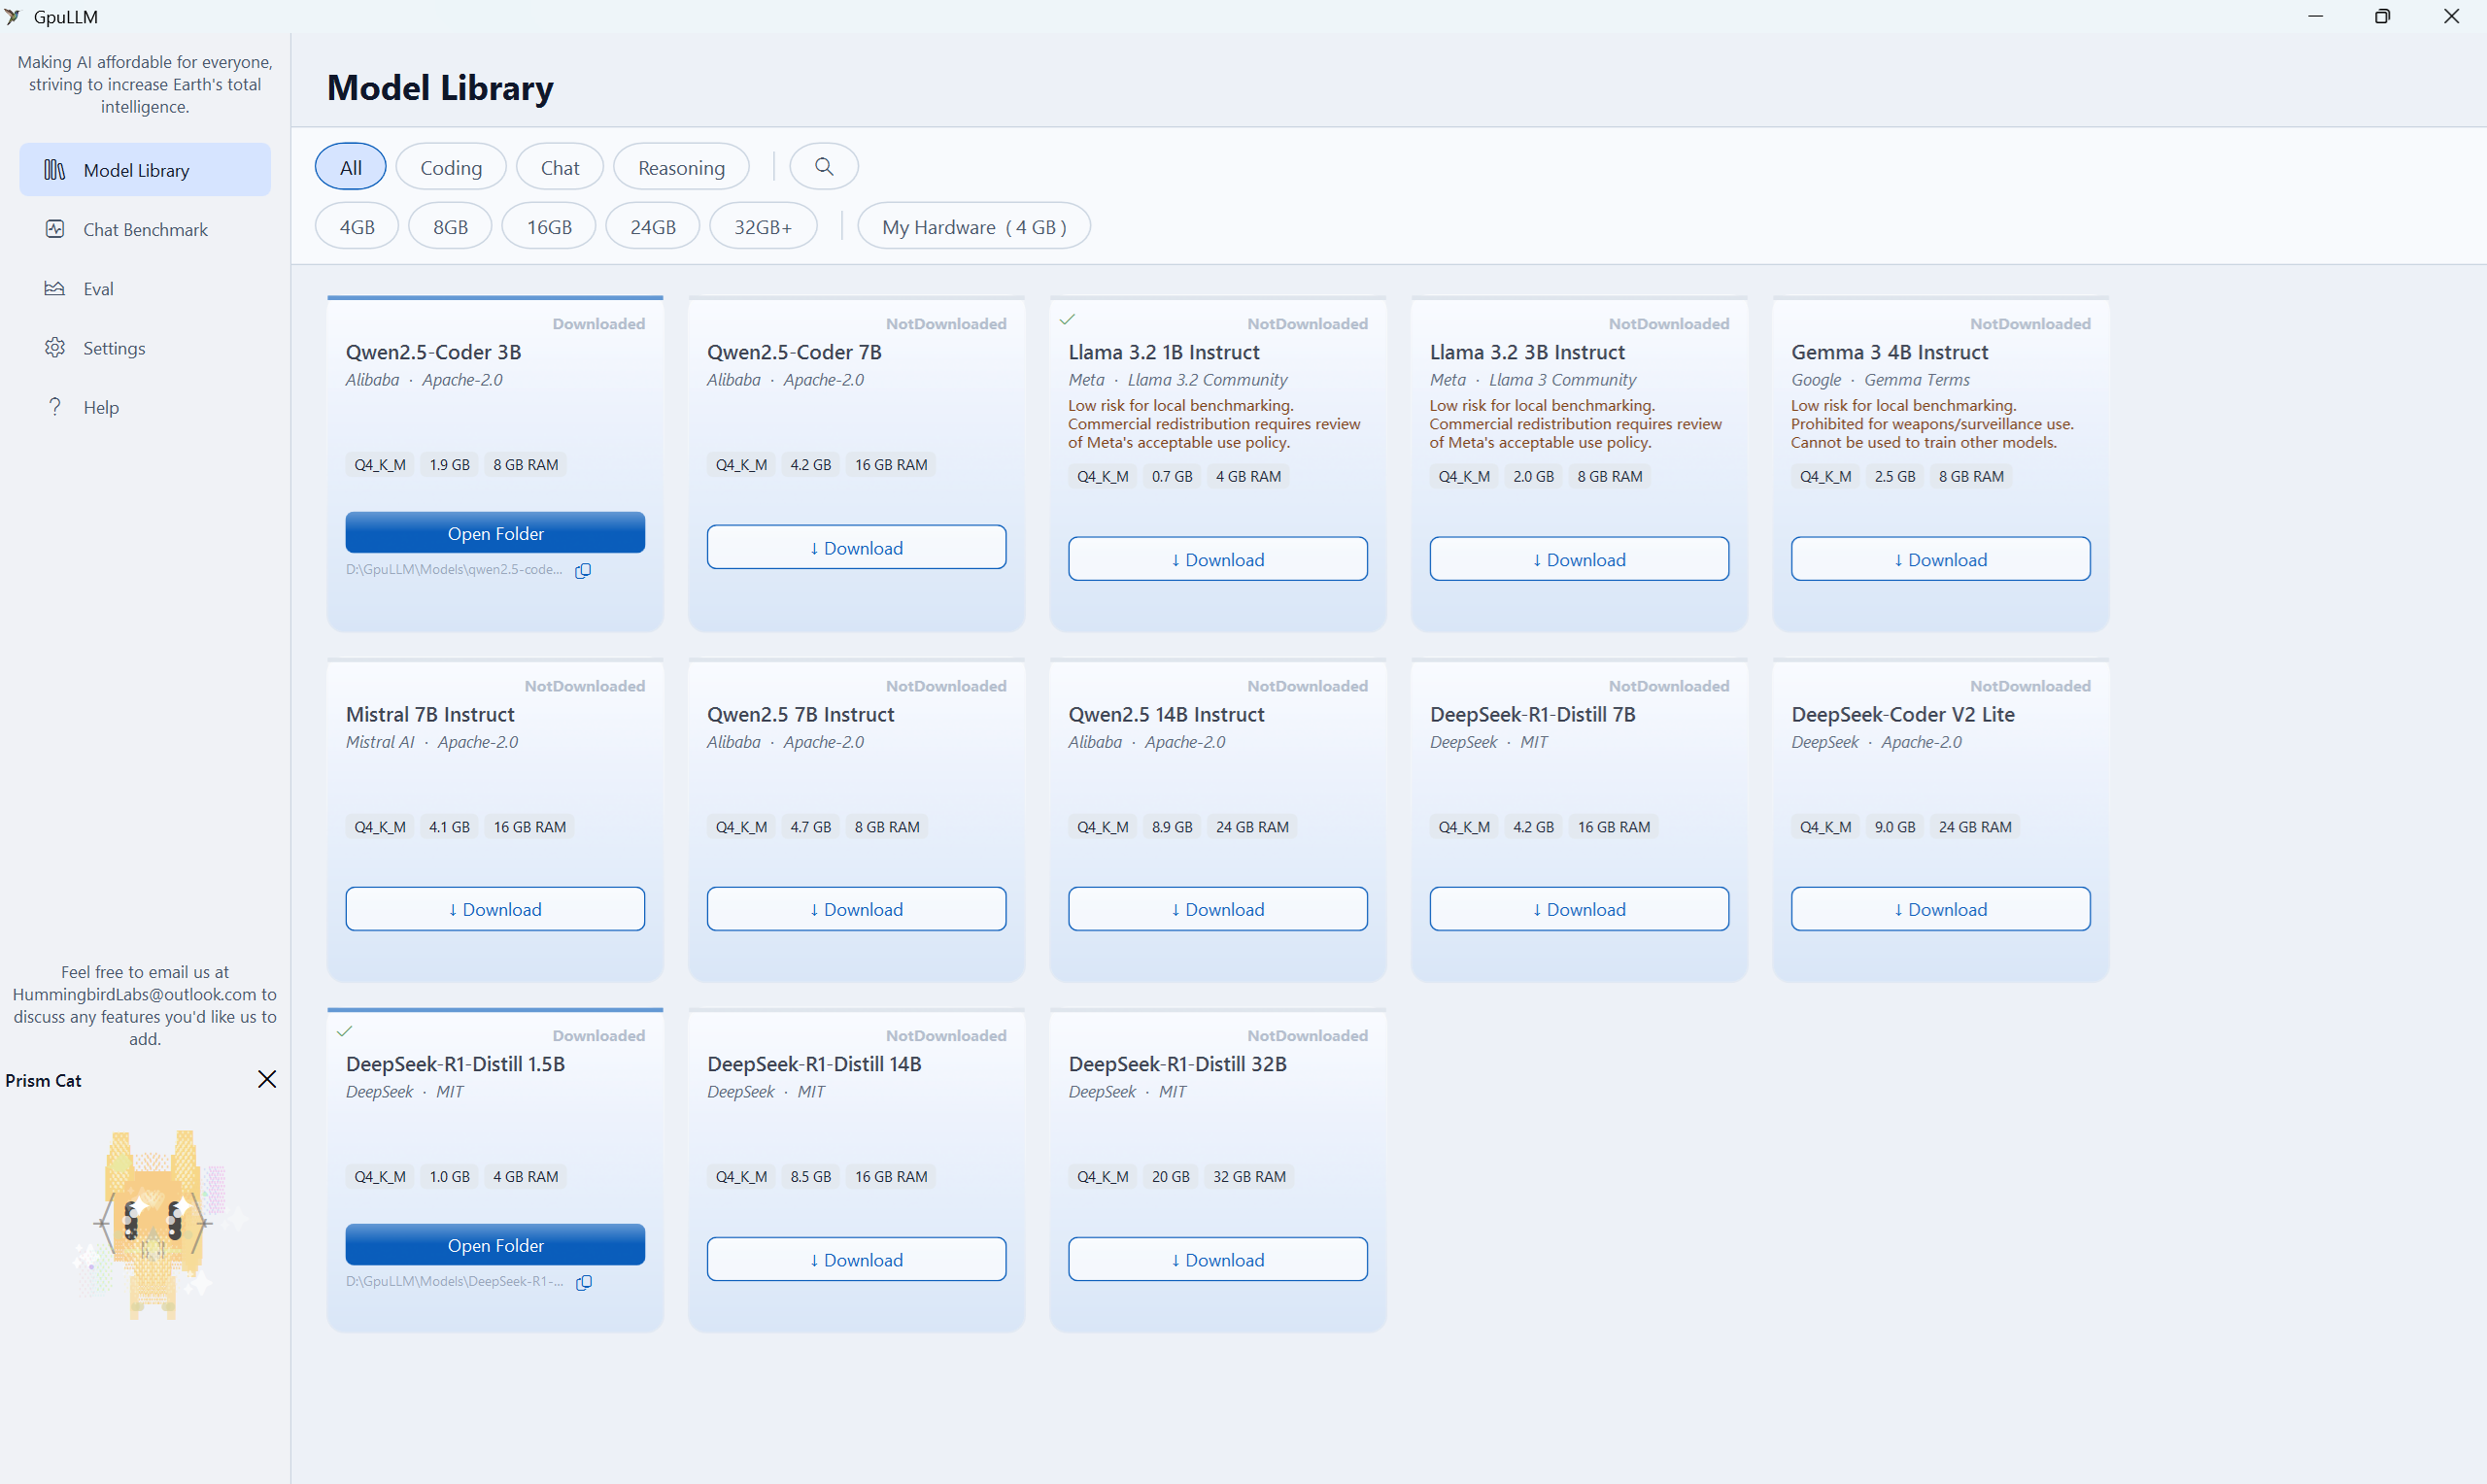
Modellbibliothek – kuratierte LLM-Modelle durchsuchen, filtern und herunterladen
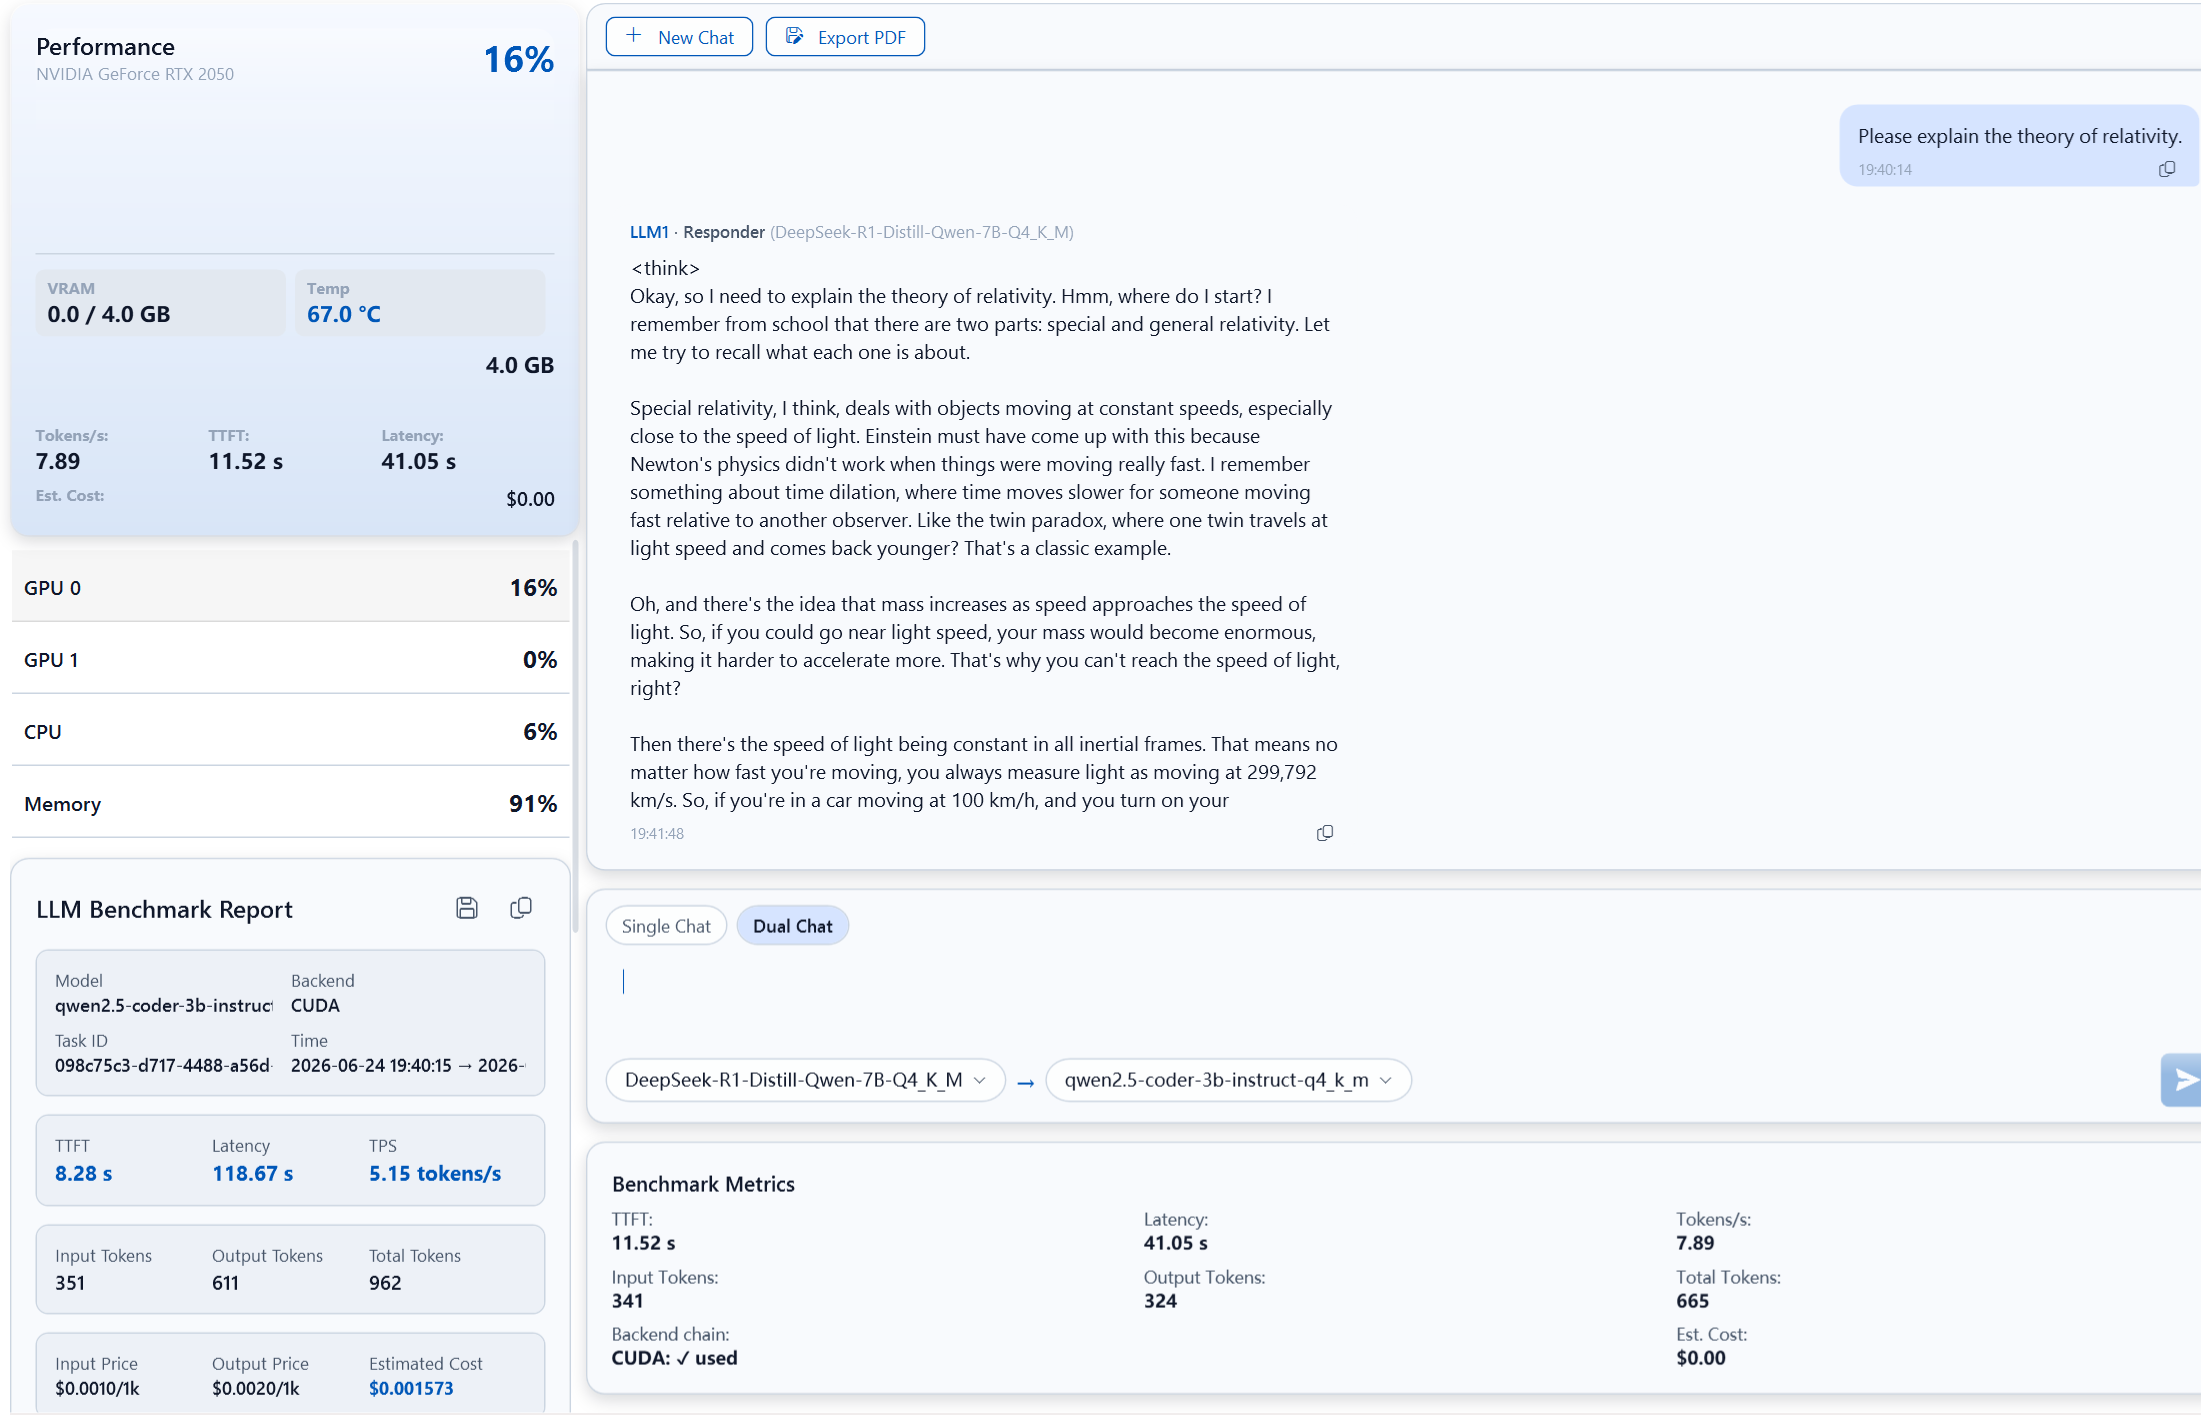
Chat-Benchmark – dualer Chat mit GPU-Überwachung und Echtzeit-Werten
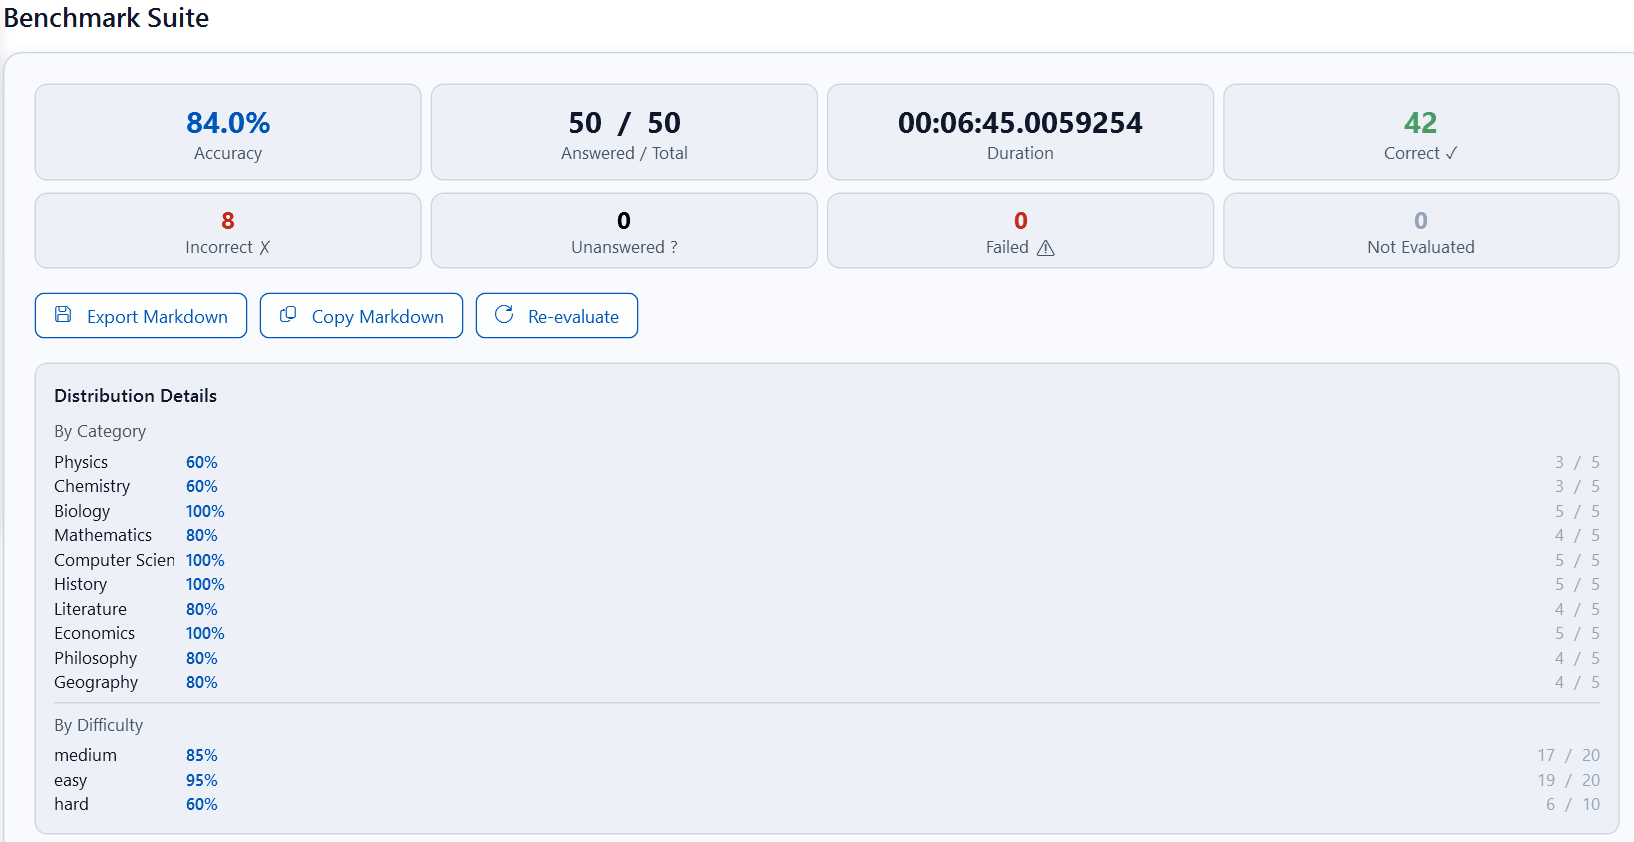
Benchmark-Ergebnisse – Trefferquote, Kategorienverteilung und Schwierigkeitsaufschlüsselung
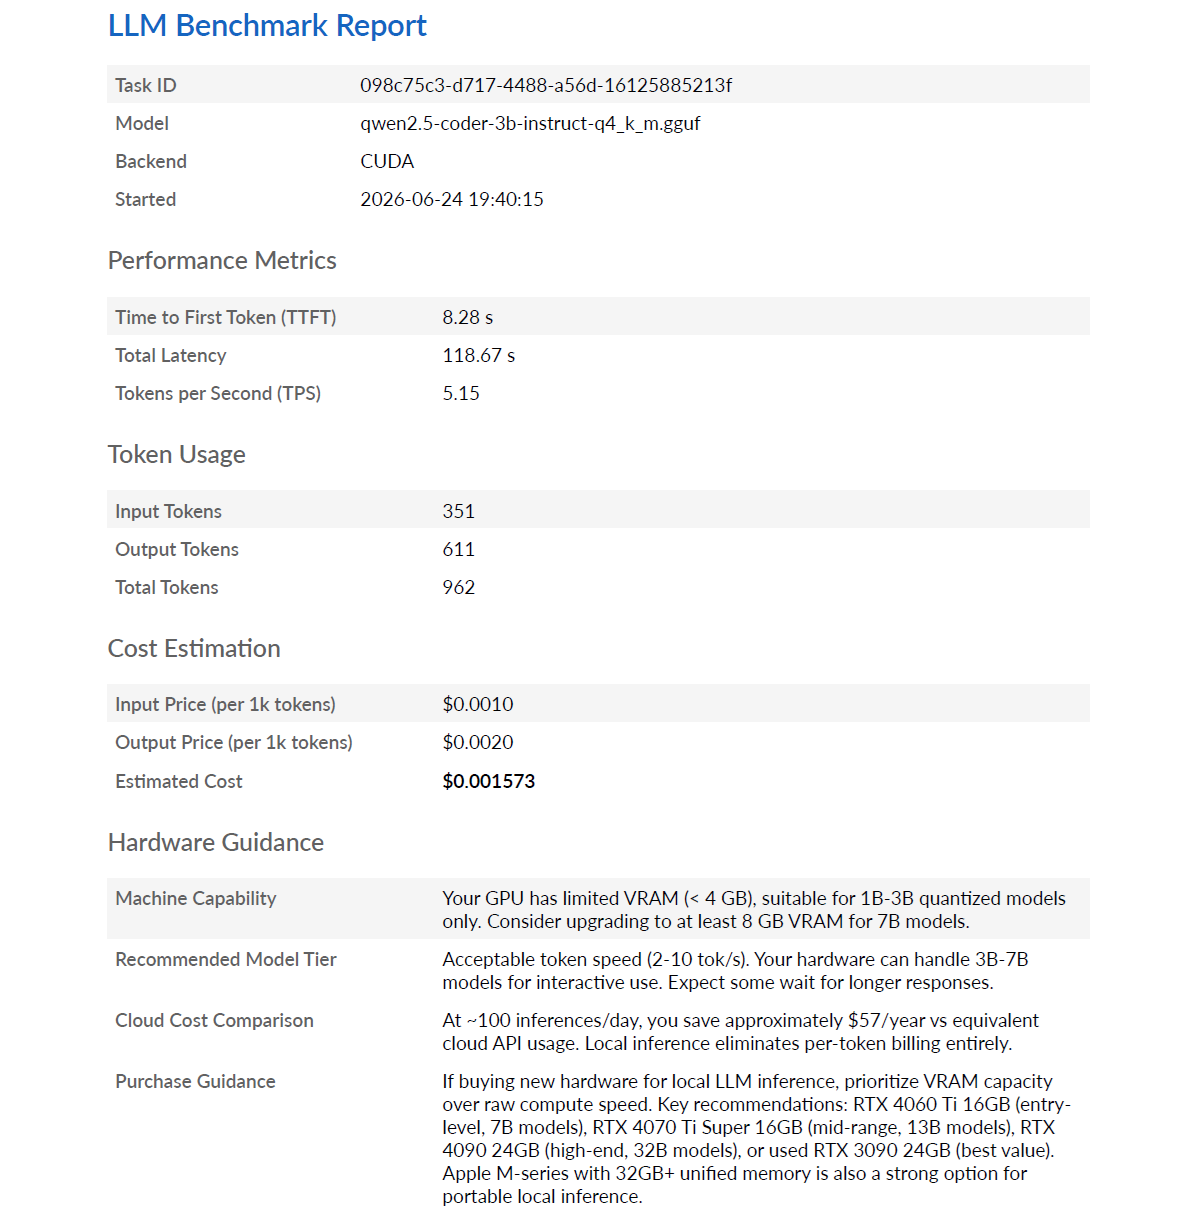
LLM-Benchmark-Bericht – Leistungswerte, Kostenschätzung und Hardware-Empfehlung

Alles, was du brauchst – und es ist kostenlos

GpuLLM ist die vollständigste kostenlose Windows-Suite für die Bewertung lokaler LLMs. Hier ist alles enthalten – ohne Abos, ohne Bezahlschranken.

Lokale LLM-Inferenz

Führe große Sprachmodelle im GGUF-Format direkt auf deiner GPU aus – mit LLamaSharp und llama.cpp-Backend. Unterstützt CUDA, Vulkan und CPU-Fallback und wählt automatisch das beste verfügbare Backend.

Lokale GGUF-Modelle importieren

Über den kuratierten Katalog hinaus kannst du jedes GGUF-Modell von deiner lokalen Festplatte importieren. Verweise GpuLLM auf deine eigenen GGUF-Dateien und chatte sofort mit eigenen oder Community-Modellen – ganz ohne Cloud-Upload.

GPU-Überwachung in Echtzeit

Verfolge GPU-Auslastung, VRAM-Nutzung, Temperatur und Stromaufnahme in Echtzeit. Mit 60-Sekunden-Sparkline-Verlauf und Unterstützung mehrerer GPUs inklusive automatischer Geräteerkennung.

Chat-Benchmark & Kostenersparnis

Chatte mit einem beliebigen Modell und miss sofort die Token-Erzeugungsgeschwindigkeit deiner GPU (Tokens/s), die Zeit bis zum ersten Token und die Gesamtlatenz. Der eingebaute Kostenschätzer vergleicht deine lokale Inferenz mit Cloud-API-Preisen – du siehst genau, wie viel Geld du durch lokale Modelle sparst.

Modellbibliothek & -verwaltung

Durchsuche 13 kuratierte Modelle, darunter Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 und Mistral. Filtere nach Kategorie – Programmieren, Chat oder Reasoning – und prüfe die VRAM-Kompatibilität mit einem Klick.

Download von HuggingFace

Lade Modelle direkt vom HuggingFace Hub oder ModelScope herunter. Mit fortsetzbaren Downloads, SHA-256-Prüfung, Mehrfachquellen-Fallback und Verwaltung der Lizenz-Zustimmungen.

Zwei-Modell-Konversation: Antwortender & Prüfer

Ein neues Interaktionsmuster: Weise in einem Chat zwei LLM-Rollen zu – einen Antwortenden, der deine Fragen beantwortet, und einen Prüfer, der die Antwort kritisch bewertet und verbessert. Dieses LLM-als-Prichter-/Agenten-Debatten-Muster lässt dich die Stärken zweier Modelle gleichzeitig für höherwertige, selbstkorrigierende Gespräche nutzen.

GPU-Spirit-Animation

Prism Cat – ein lebendig animiertes Maskottchen, das auf deine GPU-Auslastung reagiert. Beobachte, wie sich Stimmung und Farbe der Katze live verändern, wenn die Inferenzlast steigt.

Bewertung der Modellfähigkeiten

Benchmarke deine Modelle gegen umfassende Fragenkataloge: 100 englische Fragen (MMLU, Stichprobe aus 57 Fächern) und 100 chinesische Fragen (C-Eval) zu über 10 Dimensionen – Mathematik, Physik, Chemie, Biologie, Informatik, Geschichte, Literatur, Wirtschaft, Philosophie und Geografie. Du bekommst Trefferquoten je Kategorie, eine Schwierigkeitsaufschlüsselung und exportierbare Markdown-Berichte.

Detaillierter Inferenz-Bericht

Jede Inferenz erzeugt einen detaillierten Bericht mit Backend-Kette, GPU-Spitzenwerten und Token-Statistiken. Exportiere ganze Chatverläufe und Berichte als A4-PDF-Dokumente.

Was GpuLLM anders macht

GpuLLM

  • ✓Chat + Benchmark in einer Oberfläche
  • ✓Zwei-Modell-Konversation (Antwortender + Prüfer)
  • ✓MMLU- & C-Eval-Fähigkeitsbewertung
  • ✓Echtzeit-GPU-Überwachung mit Sparkline
  • ✓Schätzer für Cloud-API-Kostenersparnis
  • ✓Kuratierter Katalog mit 13 Modellen, Ein-Klick-Download
  • ✓100 % offline, keine Telemetrie
  • ✓Vollständig kostenlos – keine Abos

Andere Werkzeuge

Die meisten Alternativen lassen dich mit Modellen chatten, messen aber weder Leistung noch Trefferquote oder GPU-Werte. Du musst raten, welches Modell auf deiner Hardware am besten funktioniert – und ob du gegenüber Cloud-APIs tatsächlich sparst.

13 vorkonfigurierte Modelle, 3 Kategorien

Jeder Eintrag enthält das korrekte HuggingFace-Repo, die Quantisierung und Dateigröße – Ein-Klick-Download.

AnzeigenameEntwicklerKategorieGrößeVRAM
Qwen2.5-Coder 3BAlibabaCoding1.9 GB8 GB
Qwen2.5-Coder 7BAlibabaCoding4.2 GB16 GB
DeepSeek-Coder V2 LiteDeepSeekCoding9.0 GB24 GB
Llama 3.2 1B InstructMetaChat0.7 GB4 GB
Llama 3.2 3B InstructMetaChat2.0 GB8 GB
Gemma 3 4B InstructGoogleChat2.5 GB8 GB
Mistral 7B InstructMistral AIChat4.1 GB16 GB
Qwen2.5 7B InstructAlibabaChat4.7 GB8 GB
Qwen2.5 14B InstructAlibabaChat8.9 GB24 GB
DeepSeek-R1-Distill 1.5BDeepSeekReasoning1.0 GB4 GB
DeepSeek-R1-Distill 7BDeepSeekReasoning4.2 GB16 GB
DeepSeek-R1-Distill 14BDeepSeekReasoning8.5 GB16 GB
DeepSeek-R1-Distill 32BDeepSeekReasoning20 GB32 GB

100 % offline. 100 % kostenlos. Keine Haken.

LLamaSharp / llama.cpp

Hochleistungsfähige C++-Inferenz-Engine mit verwalteten .NET-Bindungen – dasselbe Backend, das unzählige lokale KI-Anwendungen weltweit antreibt.

WPF-UI (Fluent Design)

Moderne Windows-Desktop-Oberfläche mit Komponenten des Fluent Design Systems. Unterstützung für helle/dunkle Themes mit Glasmaterial und flüssigen Animationen.

Mehrstufiger Backend-Fallback

Automatische Fallback-Kette CUDA 12 → Vulkan → CPU. Die App erkennt die verfügbare Hardware und wählt ohne manuelle Konfiguration das schnellste Backend.

Datenschutz durch Technikgestaltung

Modellinferenz, Datenverarbeitung und Dateioperationen laufen ausschließlich auf deinem lokalen Gerät. Keine Telemetrie, keine Cloud-Abhängigkeit, kein Netzwerk erforderlich, sobald die Modelle heruntergeladen sind.

Lokale LLM-Benchmarks verstehen

Was sind Tokens/s?

Token pro Sekunde messen, wie schnell ein Sprachmodell Text erzeugt. Höhere Tokens/s bedeuten flüssigere Gespräche. GpuLLM misst sowohl Spitzen- als auch Dauer-Durchsatz und gibt dir so ein vollständiges Bild der LLM-Leistung deiner GPU.

Was ist TTFT?

Die Time To First Token (TTFT) misst die Latenz zwischen dem Absenden einer Aufforderung und dem ersten Wort der Antwort. Eine niedrigere TTFT bedeutet reaktionsschnellere Gespräche. GpuLLM verfolgt die TTFT, um die Reaktionsgeschwindigkeit von Modellen zu vergleichen.

Was ist MMLU?

Massive Multitask Language Understanding (MMLU) ist ein Standard-Benchmark, der Wissen in 57 Fächern prüft. GpuLLM enthält 100 Stichprobenfragen, um die Wissensbreite und das Schlussfolgerungsvermögen deines Modells zu bewerten.

Was ist C-Eval?

C-Eval ist eine chinesische Bewertungssuite zu 52 Disziplinen in vier Schwierigkeitsstufen. GpuLLM enthält 100 Fragen, um das chinesische Sprachverständnis und das Fachwissen deines Modells zu testen.

Häufig gestellte Fragen

Ist GpuLLM wirklich kostenlos?
Ja. GpuLLM ist vollständig kostenlos, ohne Abo, ohne Bezahlschranke und ohne versteckte Kosten. Jede Funktion – Chat, Benchmark, GPU-Überwachung und Modellbewertung – ist kostenlos enthalten.
Funktioniert GpuLLM offline?
Ja. Die gesamte Inferenz läuft zu 100 % auf deinem lokalen Rechner. Das Einzige, was überhaupt ins Internet geht, ist der Modell-Download von HuggingFace oder ModelScope. Nach dem Download wird keine Internetverbindung mehr benötigt.
Welche Modelle kann ich mit GpuLLM ausführen?
GpuLLM unterstützt alle Modelle im GGUF-Format. Ein kuratierter Katalog mit 13 Modellen ist enthalten, darunter Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 und Mistral. Du kannst darüber hinaus jede GGUF-Datei von deiner lokalen Festplatte importieren.
Worin unterscheidet sich GpuLLM von anderen LLM-Werkzeugen?
Die meisten Alternativen lassen dich mit Modellen chatten, messen aber weder Leistung noch Trefferquote oder GPU-Werte. GpuLLM ist die einzige kostenlose Windows-App, die Chat, Benchmark, GPU-Überwachung, Modellbewertung (MMLU/C-Eval) und Kostenschätzung in einem Paket vereint.
Wie fange ich mit GpuLLM an?
Lade GpuLLM aus dem Microsoft Store, wähle in der Modellbibliothek ein passendes Modell für den VRAM deiner GPU, klicke auf Download und dann auf Laden und beginne im Chat-Benchmark zu chatten. Eine vollständige Anleitung findest du im Hilfebereich.

GpuLLM ist ein Windows-Desktop-Programm. Inferenz, Benchmark und Bewertung laufen lokal auf deinem Gerät. Weder Modelldaten noch Chat-Inhalte werden je auf einen Server hochgeladen. Der Download-Link öffnet den Microsoft Store in deinem Standardbrowser.

All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.