トークン/秒とは?
1秒あたりのトークン数は、言語モデルが文章を生成する速さを表します。値が大きいほど会話の応答が速くなります。GpuLLMはピークと持続の両方のスループットを測定し、GPUのLLM性能を総合的に把握できます。
Windowsデスクトップアプリ
GpuLLMは、ローカルLLMを総合的に評価できるWindows用無料アプリです。推論速度(トークン/秒、レイテンシ)とモデル能力(MMLU、C-Evalの精度)の両方を測定します。チャット、ベンチマーク、GPUモニタリング、モデル管理まですべて100%オフライン。インターネットに触れるのはモデルのダウンロードだけです。数時間かけずとも数分で、自分のハードウェアに最適なモデルが見つかります。クラウド依存もAPIキーも不要で、データがマシンから外に出ることはありません。
GpuLLMは、ローカルLLM評価のための最も総合的なWindows無料ツール集です。サブスクリプションも課金の壁もありません。
LLamaSharpとllama.cppバックエンドを用い、GGUF形式の大規模言語モデルをGPUで直接実行します。CUDA、Vulkan、CPUフォールバックをサポートし、利用可能な最適なバックエンドを自動で選びます。
厳選カタログ以外にも、ローカルディスク上の任意のGGUFモデルを読み込めます。自作やコミュニティのモデルのGGUFファイルを指定するだけで、すぐにチャットを始められます。クラウドへのアップロードは不要です。
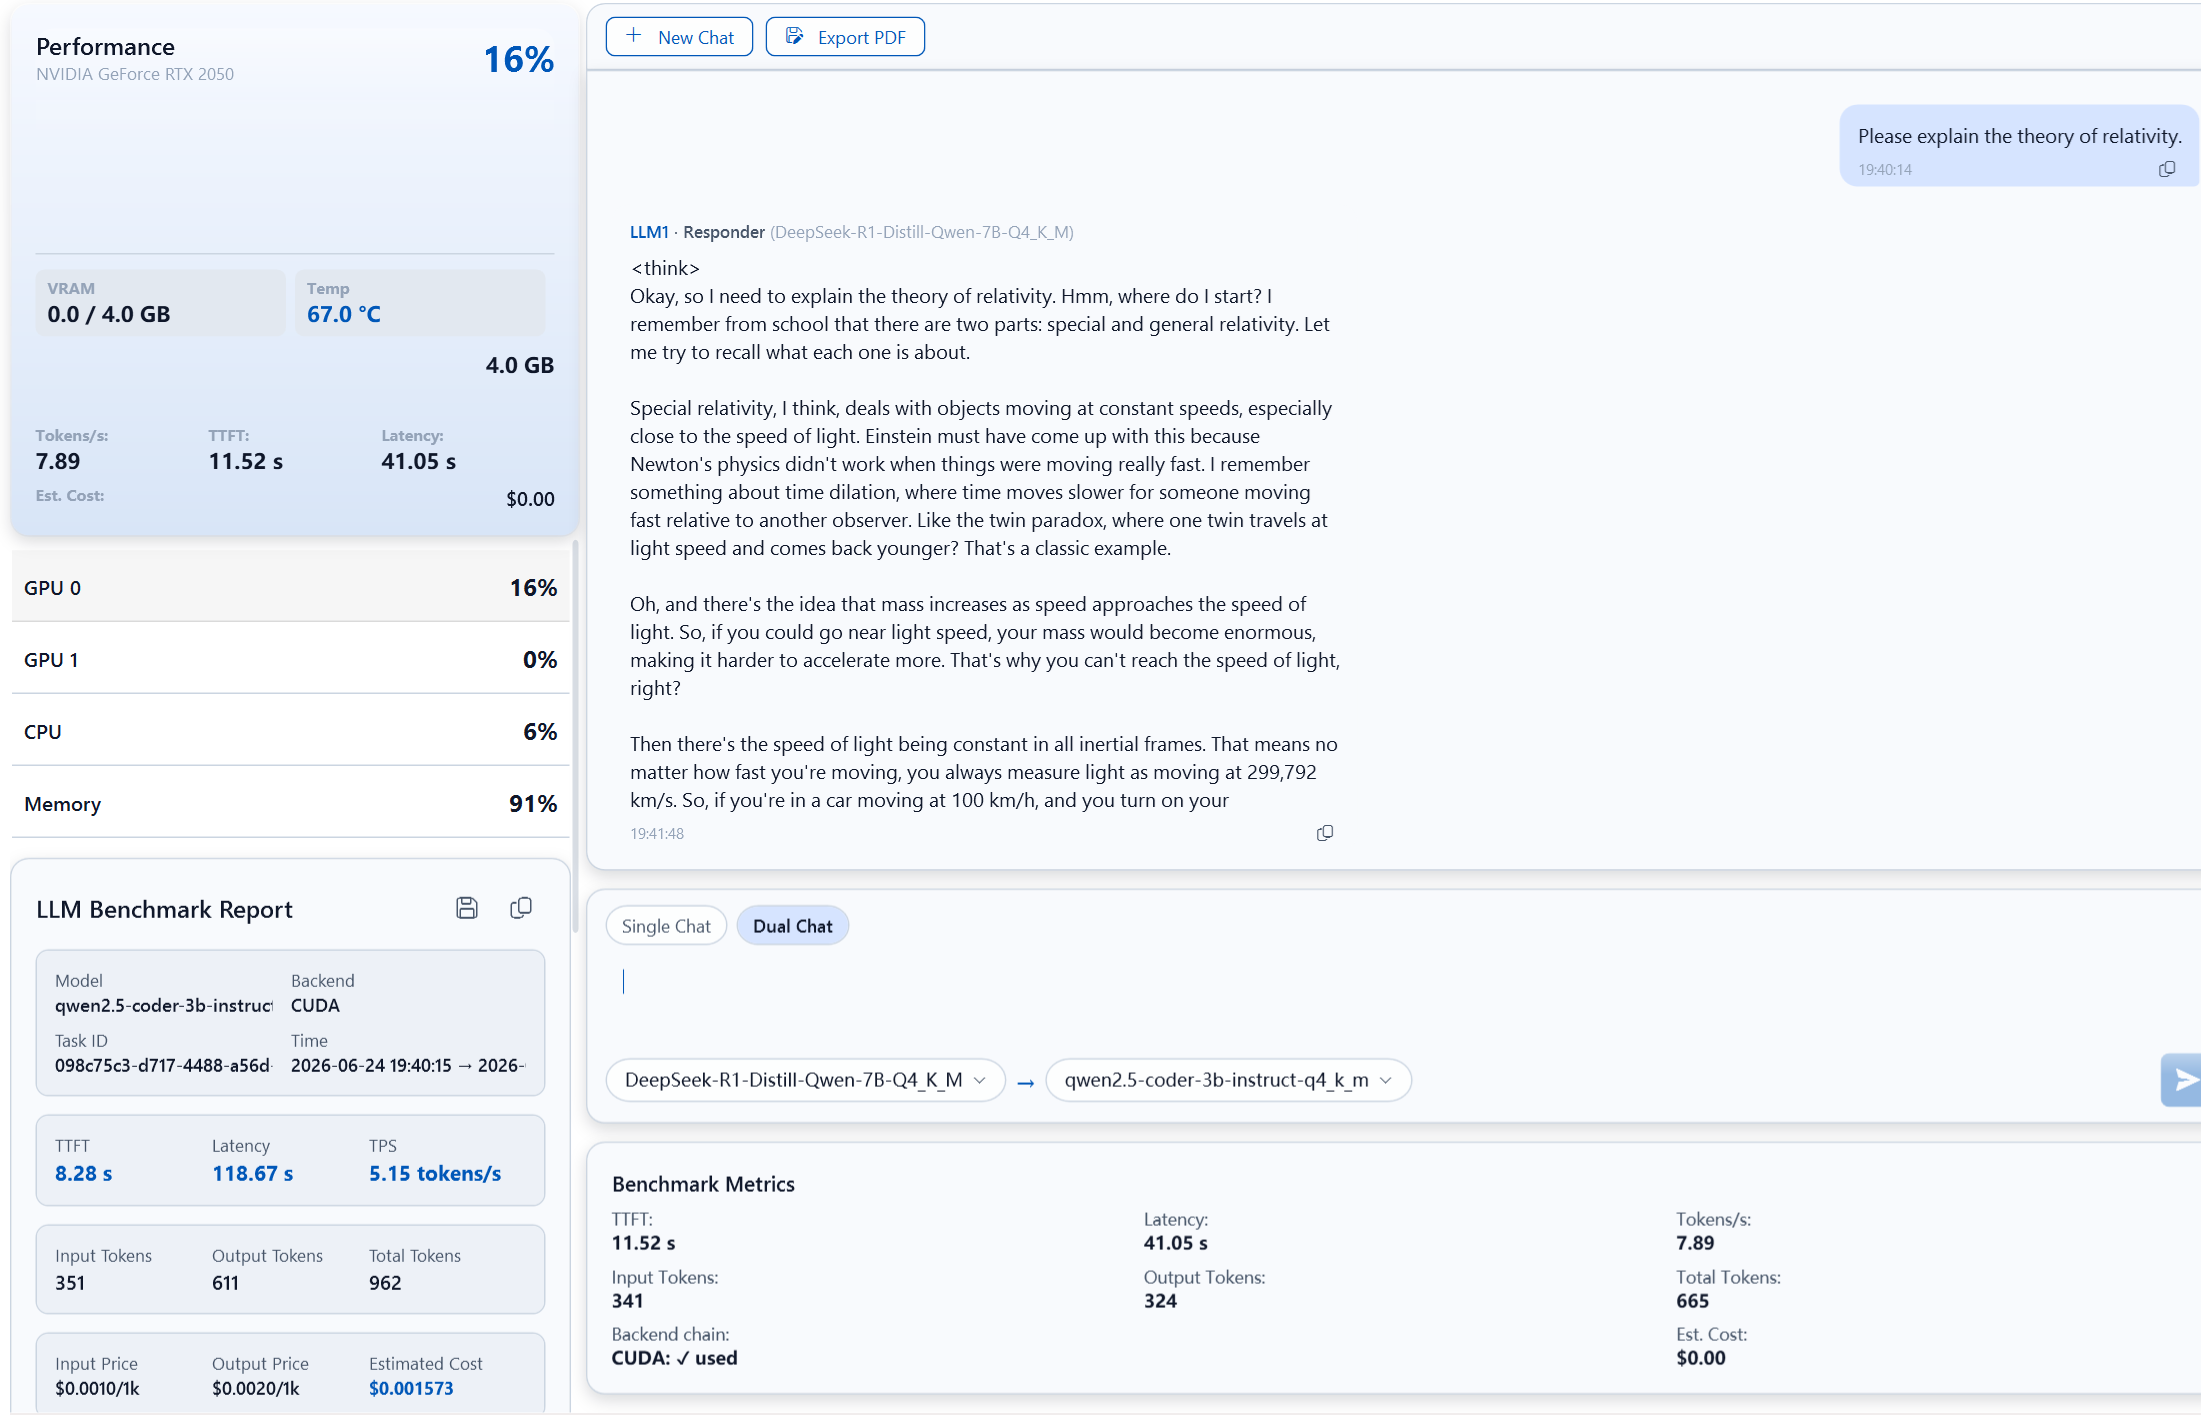
GPU使用率、VRAM使用量、温度、消費電力をリアルタイムで追跡。直近60秒のスパークライン履歴チャートと、デバイス自動検出によるマルチGPUをサポートします。
任意のモデルとチャットしながら、GPUのトークン生成速度(トークン/秒)、初トークン到達時間、合計レイテンシを即座に測定します。内蔵のコスト試算機能がローカル推論とクラウドAPI料金を比較し、ローカル実行でいくら節約できるかを表示します。
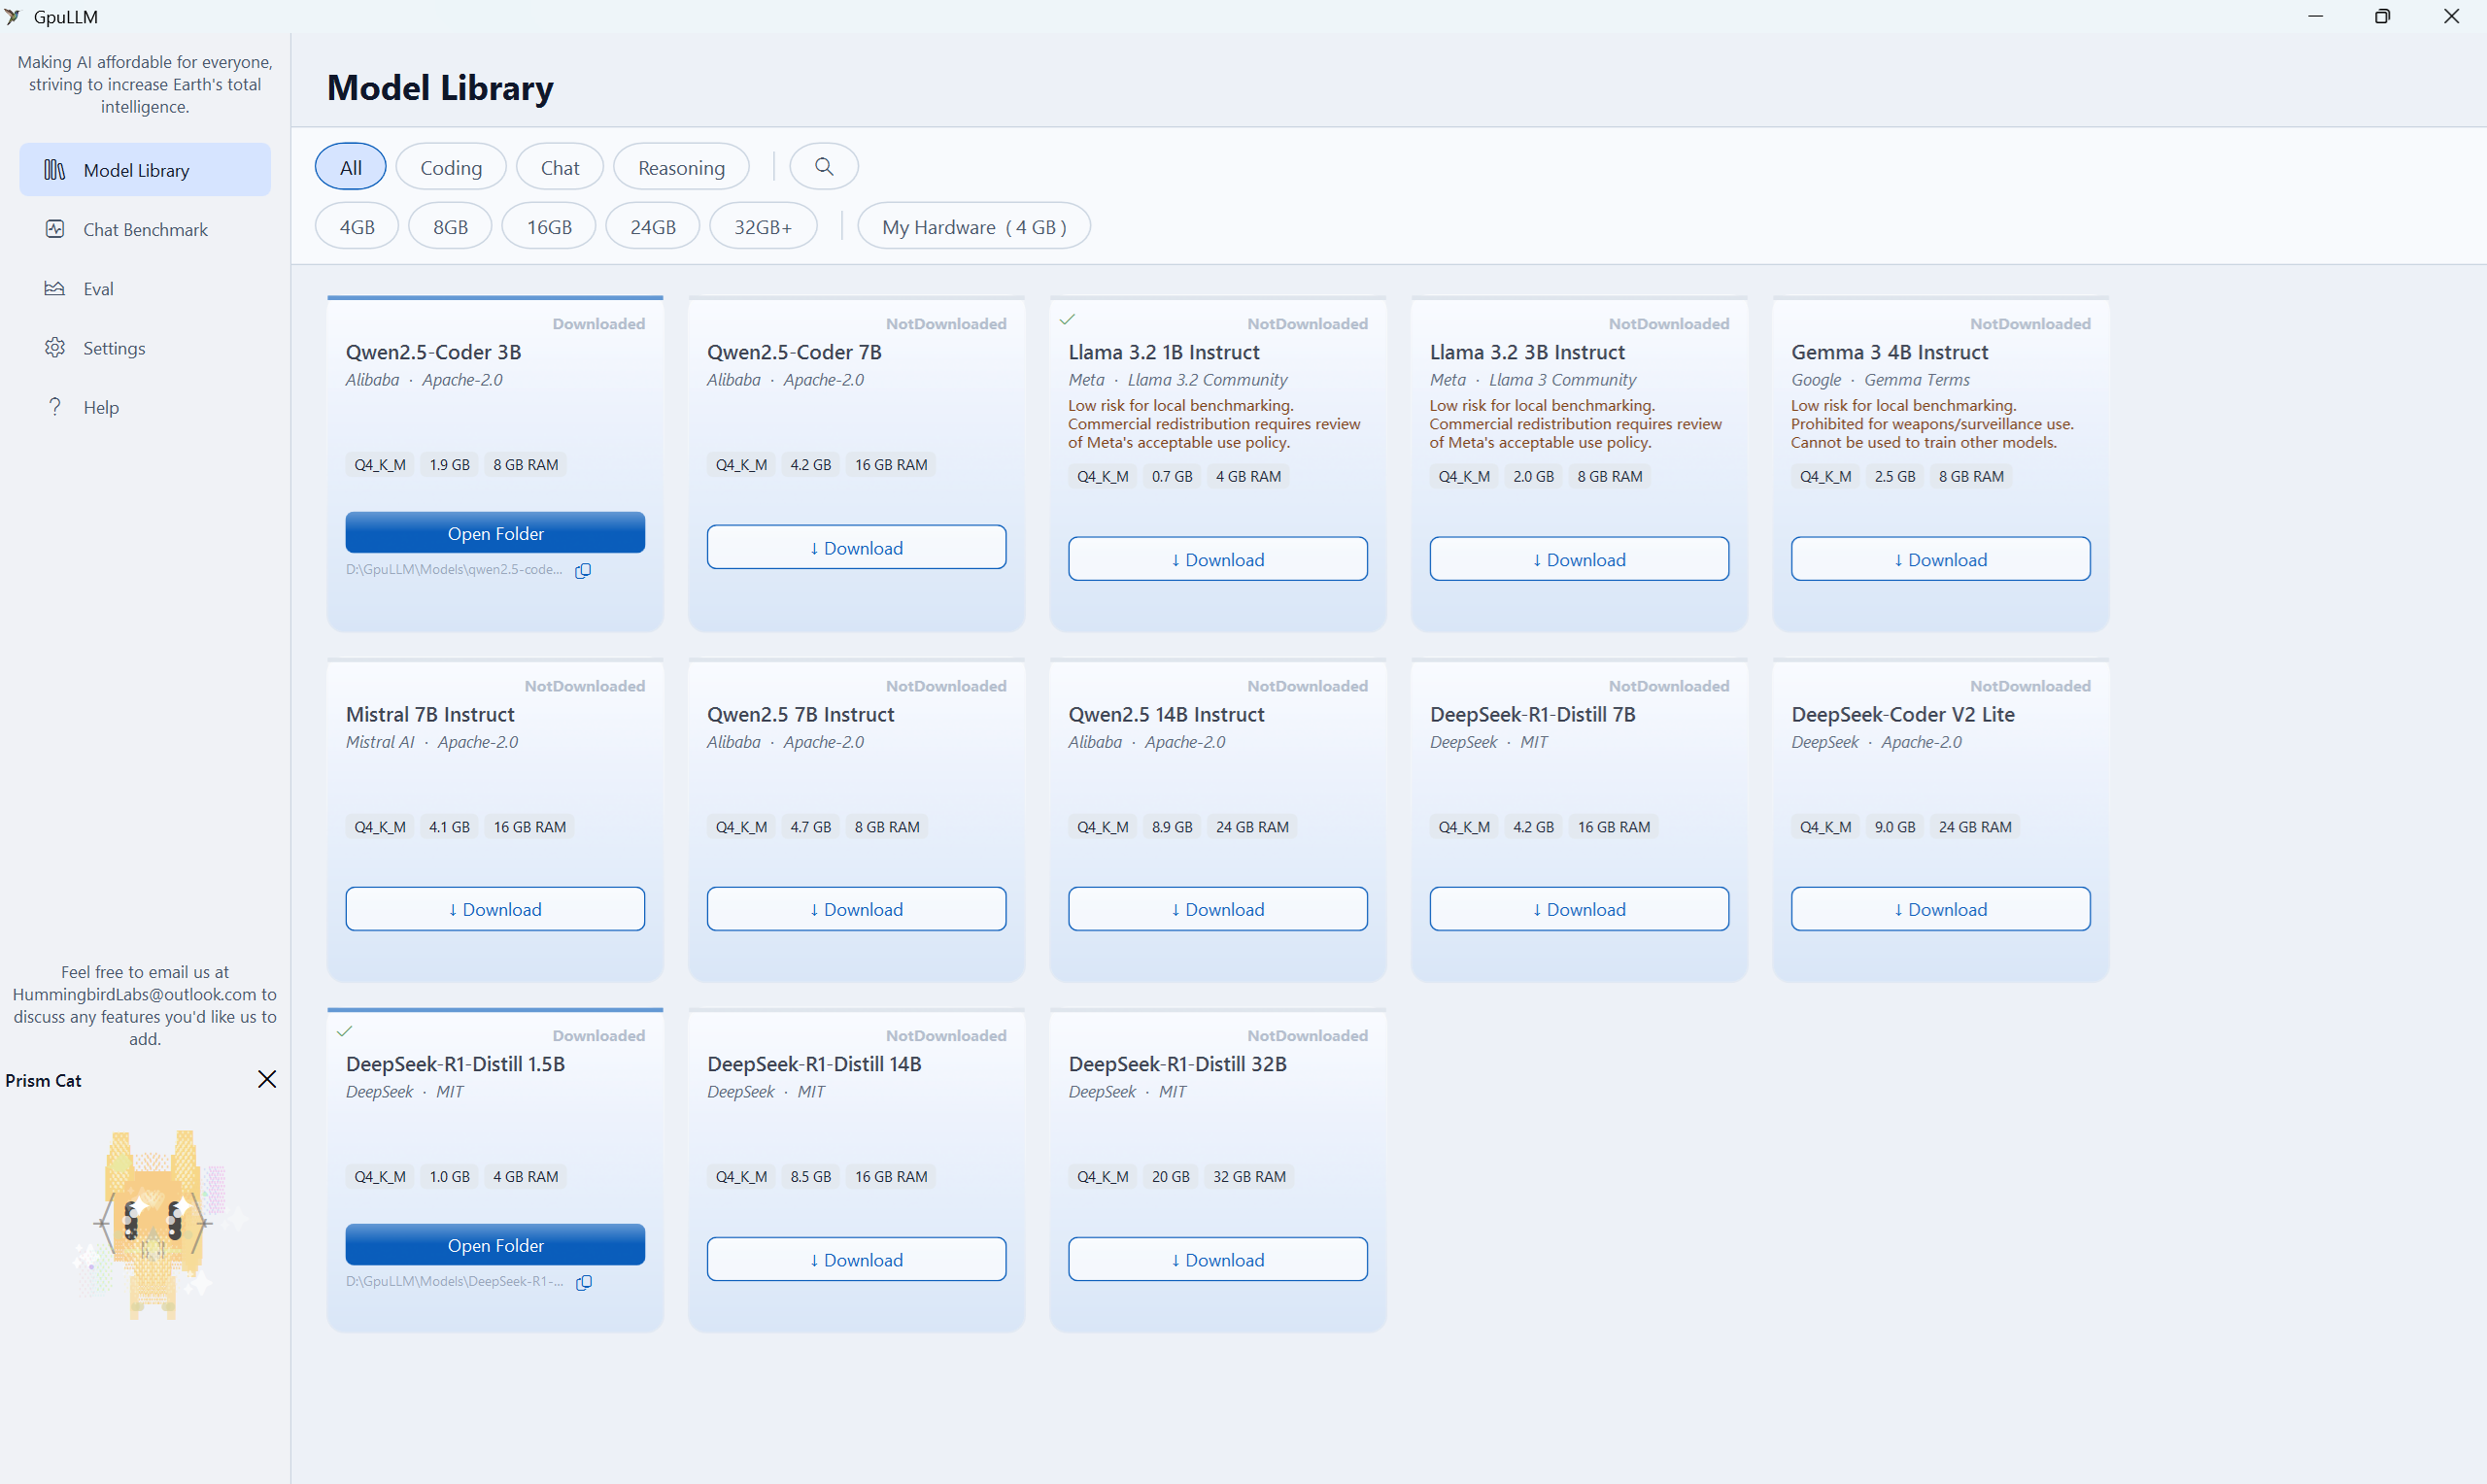
Qwen2.5-Coder、DeepSeek-R1、Llama 3.2、Gemma 3、Mistralなど厳選13モデルを収録。コーディング、チャット、推論のカテゴリで絞り込み、VRAM適合性をワンクリックで確認できます。
HuggingFace HubまたはModelScopeからモデルを直接ダウンロード。レジューム対応、SHA-256検証、複数ソースのフォールバック、ライセンス同意の管理を備えています。
新しい対話パターンを搭載。1つのチャットで、質問に答える「回答者」と、その答えを批判的に評価して改善する「批評者」の2役をLLMに割り当てます。AI研究でも注目されるLLM-as-a-Judge/エージェント討論の手法で、2つの異なるモデルの強みを同時に引き出し、自己修正する質の高い会話を実現します。
GPU使用率に反応して動くライブマスコット「プリズムキャット」。推論負荷が上がると、猫の表情と色がリアルタイムで変化します。
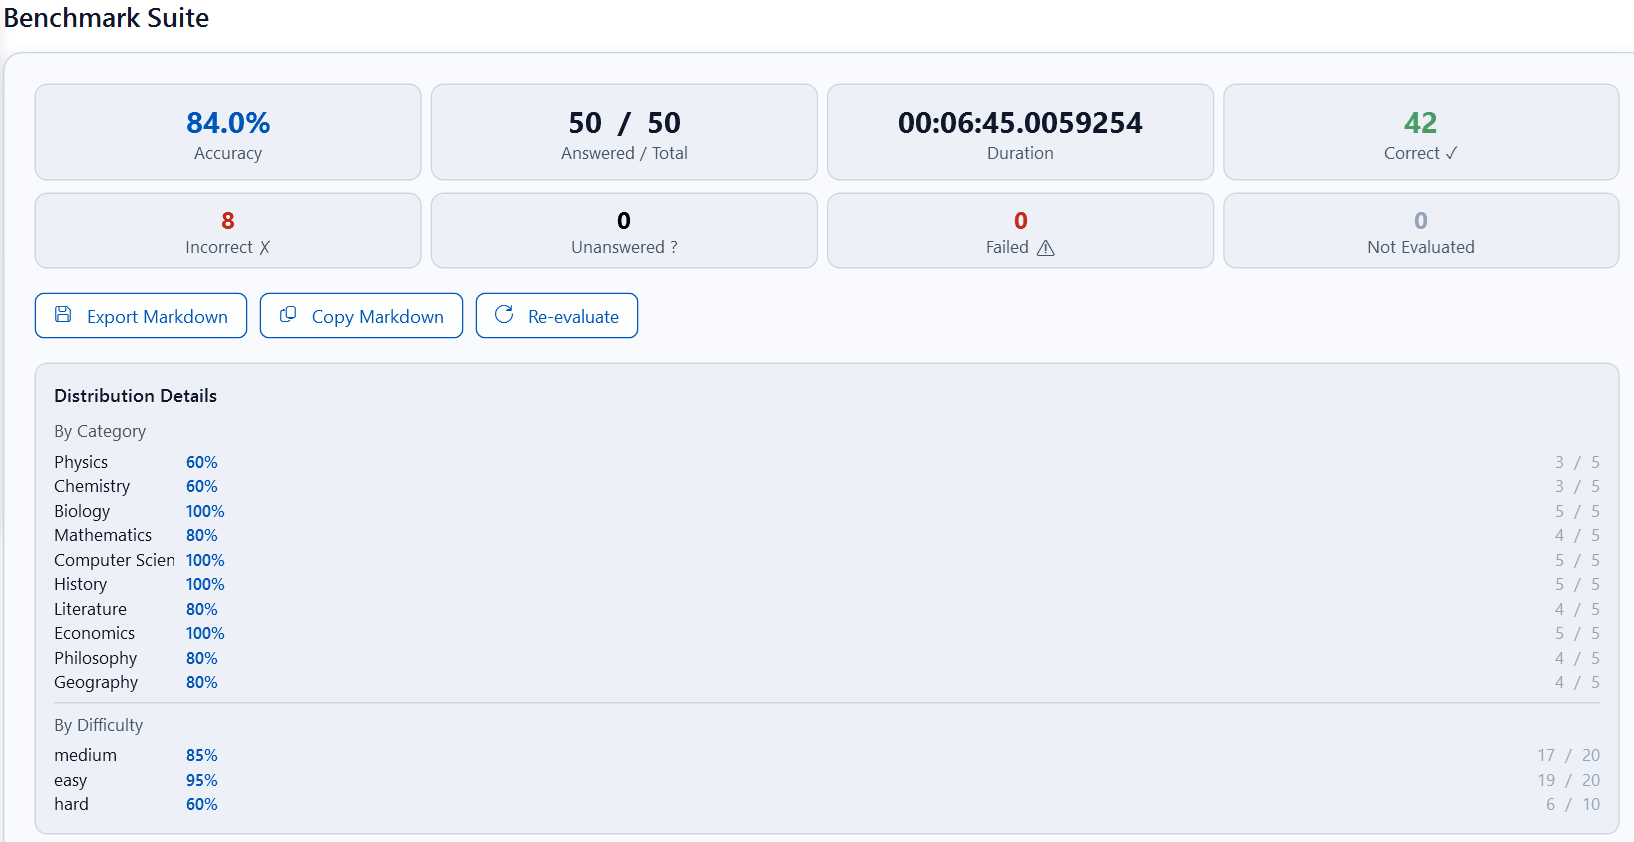
包括的な問題セットでモデルを測定:英語100問(MMLU、57科目からサンプリング)と中国語100問(C-Eval)。数学、物理、化学、生物、コンピュータ科学、歴史、文学、経済学、哲学、地理など10以上の領域をカバーします。カテゴリ別精度、難易度の内訳、Markdown形式の書き出しに対応したレポートを得られます。
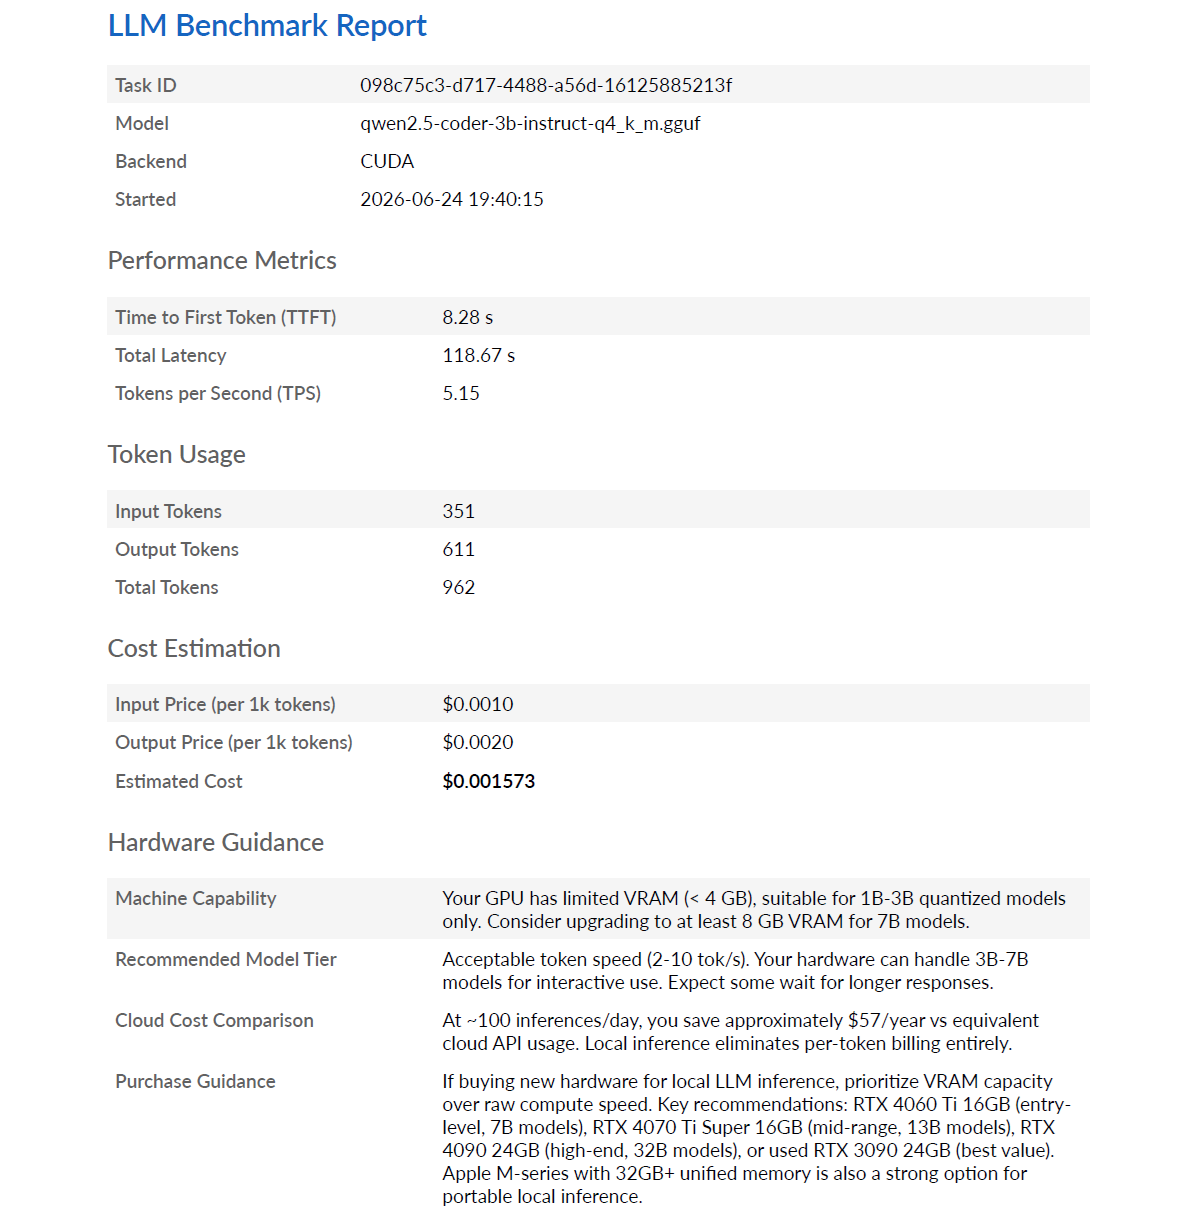
各推論ごとに、バックエンドの連鎖、GPUのピーク指標、トークン単位の統計を含む詳細レポートを生成。チャット履歴とレポートをA4のPDFとして書き出せます。
多くの代替ツールはモデルとチャットはできても、性能の測定、精度の評価、GPU指標の追跡はできません。自分のハードウェアでどのモデルが最も速いのか、クラウドAPIと比べて本当に得をしているのか、手探りになってしまいます。
正しいHuggingFaceリポジトリ、量子化、ファイルサイズを各項目に記載済み。ワンクリックでダウンロードできます。
| 表示名 | 開発元 | カテゴリ | サイズ | VRAM |
|---|---|---|---|---|
| Qwen2.5-Coder 3B | Alibaba | Coding | 1.9 GB | 8 GB |
| Qwen2.5-Coder 7B | Alibaba | Coding | 4.2 GB | 16 GB |
| DeepSeek-Coder V2 Lite | DeepSeek | Coding | 9.0 GB | 24 GB |
| Llama 3.2 1B Instruct | Meta | Chat | 0.7 GB | 4 GB |
| Llama 3.2 3B Instruct | Meta | Chat | 2.0 GB | 8 GB |
| Gemma 3 4B Instruct | Chat | 2.5 GB | 8 GB | |
| Mistral 7B Instruct | Mistral AI | Chat | 4.1 GB | 16 GB |
| Qwen2.5 7B Instruct | Alibaba | Chat | 4.7 GB | 8 GB |
| Qwen2.5 14B Instruct | Alibaba | Chat | 8.9 GB | 24 GB |
| DeepSeek-R1-Distill 1.5B | DeepSeek | Reasoning | 1.0 GB | 4 GB |
| DeepSeek-R1-Distill 7B | DeepSeek | Reasoning | 4.2 GB | 16 GB |
| DeepSeek-R1-Distill 14B | DeepSeek | Reasoning | 8.5 GB | 16 GB |
| DeepSeek-R1-Distill 32B | DeepSeek | Reasoning | 20 GB | 32 GB |
高性能なC++推論エンジンとマネージド.NETバインディング。世界中の数多くのローカルAIアプリを支えるのと同じバックエンドです。
Fluent Design Systemのコンポーネントを備えたモダンなWindowsデスクトップUI。ダーク/ライトテーマ、ガラス調マテリアル、なめらかなアニメーションをサポートします。
CUDA 12 → Vulkan → CPUの自動フォールバック。利用可能なハードウェアを検出し、手動設定なしで最速のバックエンドを選びます。
モデル推論、データ処理、ファイル操作はすべてローカル端末上だけで行われます。テレメトリはなく、モデルを一度ダウンロードすればネットワークも不要です。
1秒あたりのトークン数は、言語モデルが文章を生成する速さを表します。値が大きいほど会話の応答が速くなります。GpuLLMはピークと持続の両方のスループットを測定し、GPUのLLM性能を総合的に把握できます。
TTFT(Time To First Token)は、プロンプトを送信してから応答の最初の単語が返るまでの待ち時間です。小さいほど反応が速く感じられます。GpuLLMはTTFTを記録し、モデルの応答速度を比較できます。
MMLU(Massive Multitask Language Understanding)は、57科目にわたる知識を測る標準ベンチマークです。GpuLLMにはサンプリングされた100問が収録され、モデルの知識の幅と推論力を評価できます。
C-Evalは52の学問分野と4段階の難易度をカバーする中国語の評価スイートです。GpuLLMには100問が収録され、モデルの中国語理解力と専門知識を測定できます。
GpuLLMはWindowsデスクトップアプリです。推論、ベンチマーク、評価はすべて端末上でローカルに実行され、モデルデータやチャット内容がサーバーにアップロードされることはありません。ダウンロードリンクは規定のブラウザでMicrosoft Storeを開きます。
All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.