Aplicación de escritorio para Windows

La forma más completa de medir el rendimiento y la capacidad de tus LLMs locales

GpuLLM es una aplicación gratis para Windows con la que puedes evaluar a fondo LLMs locales, midiendo tanto la velocidad de inferencia (tokens/s, latencia) como la capacidad del modelo (precisión MMLU, C-Eval). Todo es 100 % sin conexión: chat, benchmarks, monitorización de GPU y gestión de modelos; lo único que toca internet es la descarga de los modelos. Encuentra en minutos, no en horas, la combinación ideal de modelo y hardware. Sin dependencia de la nube, sin claves de API y sin que tus datos salgan del equipo.

Windows 10 / 11100% Offline11 LanguagesCUDA / Vulkan / CPU

Compruébalo tú mismo

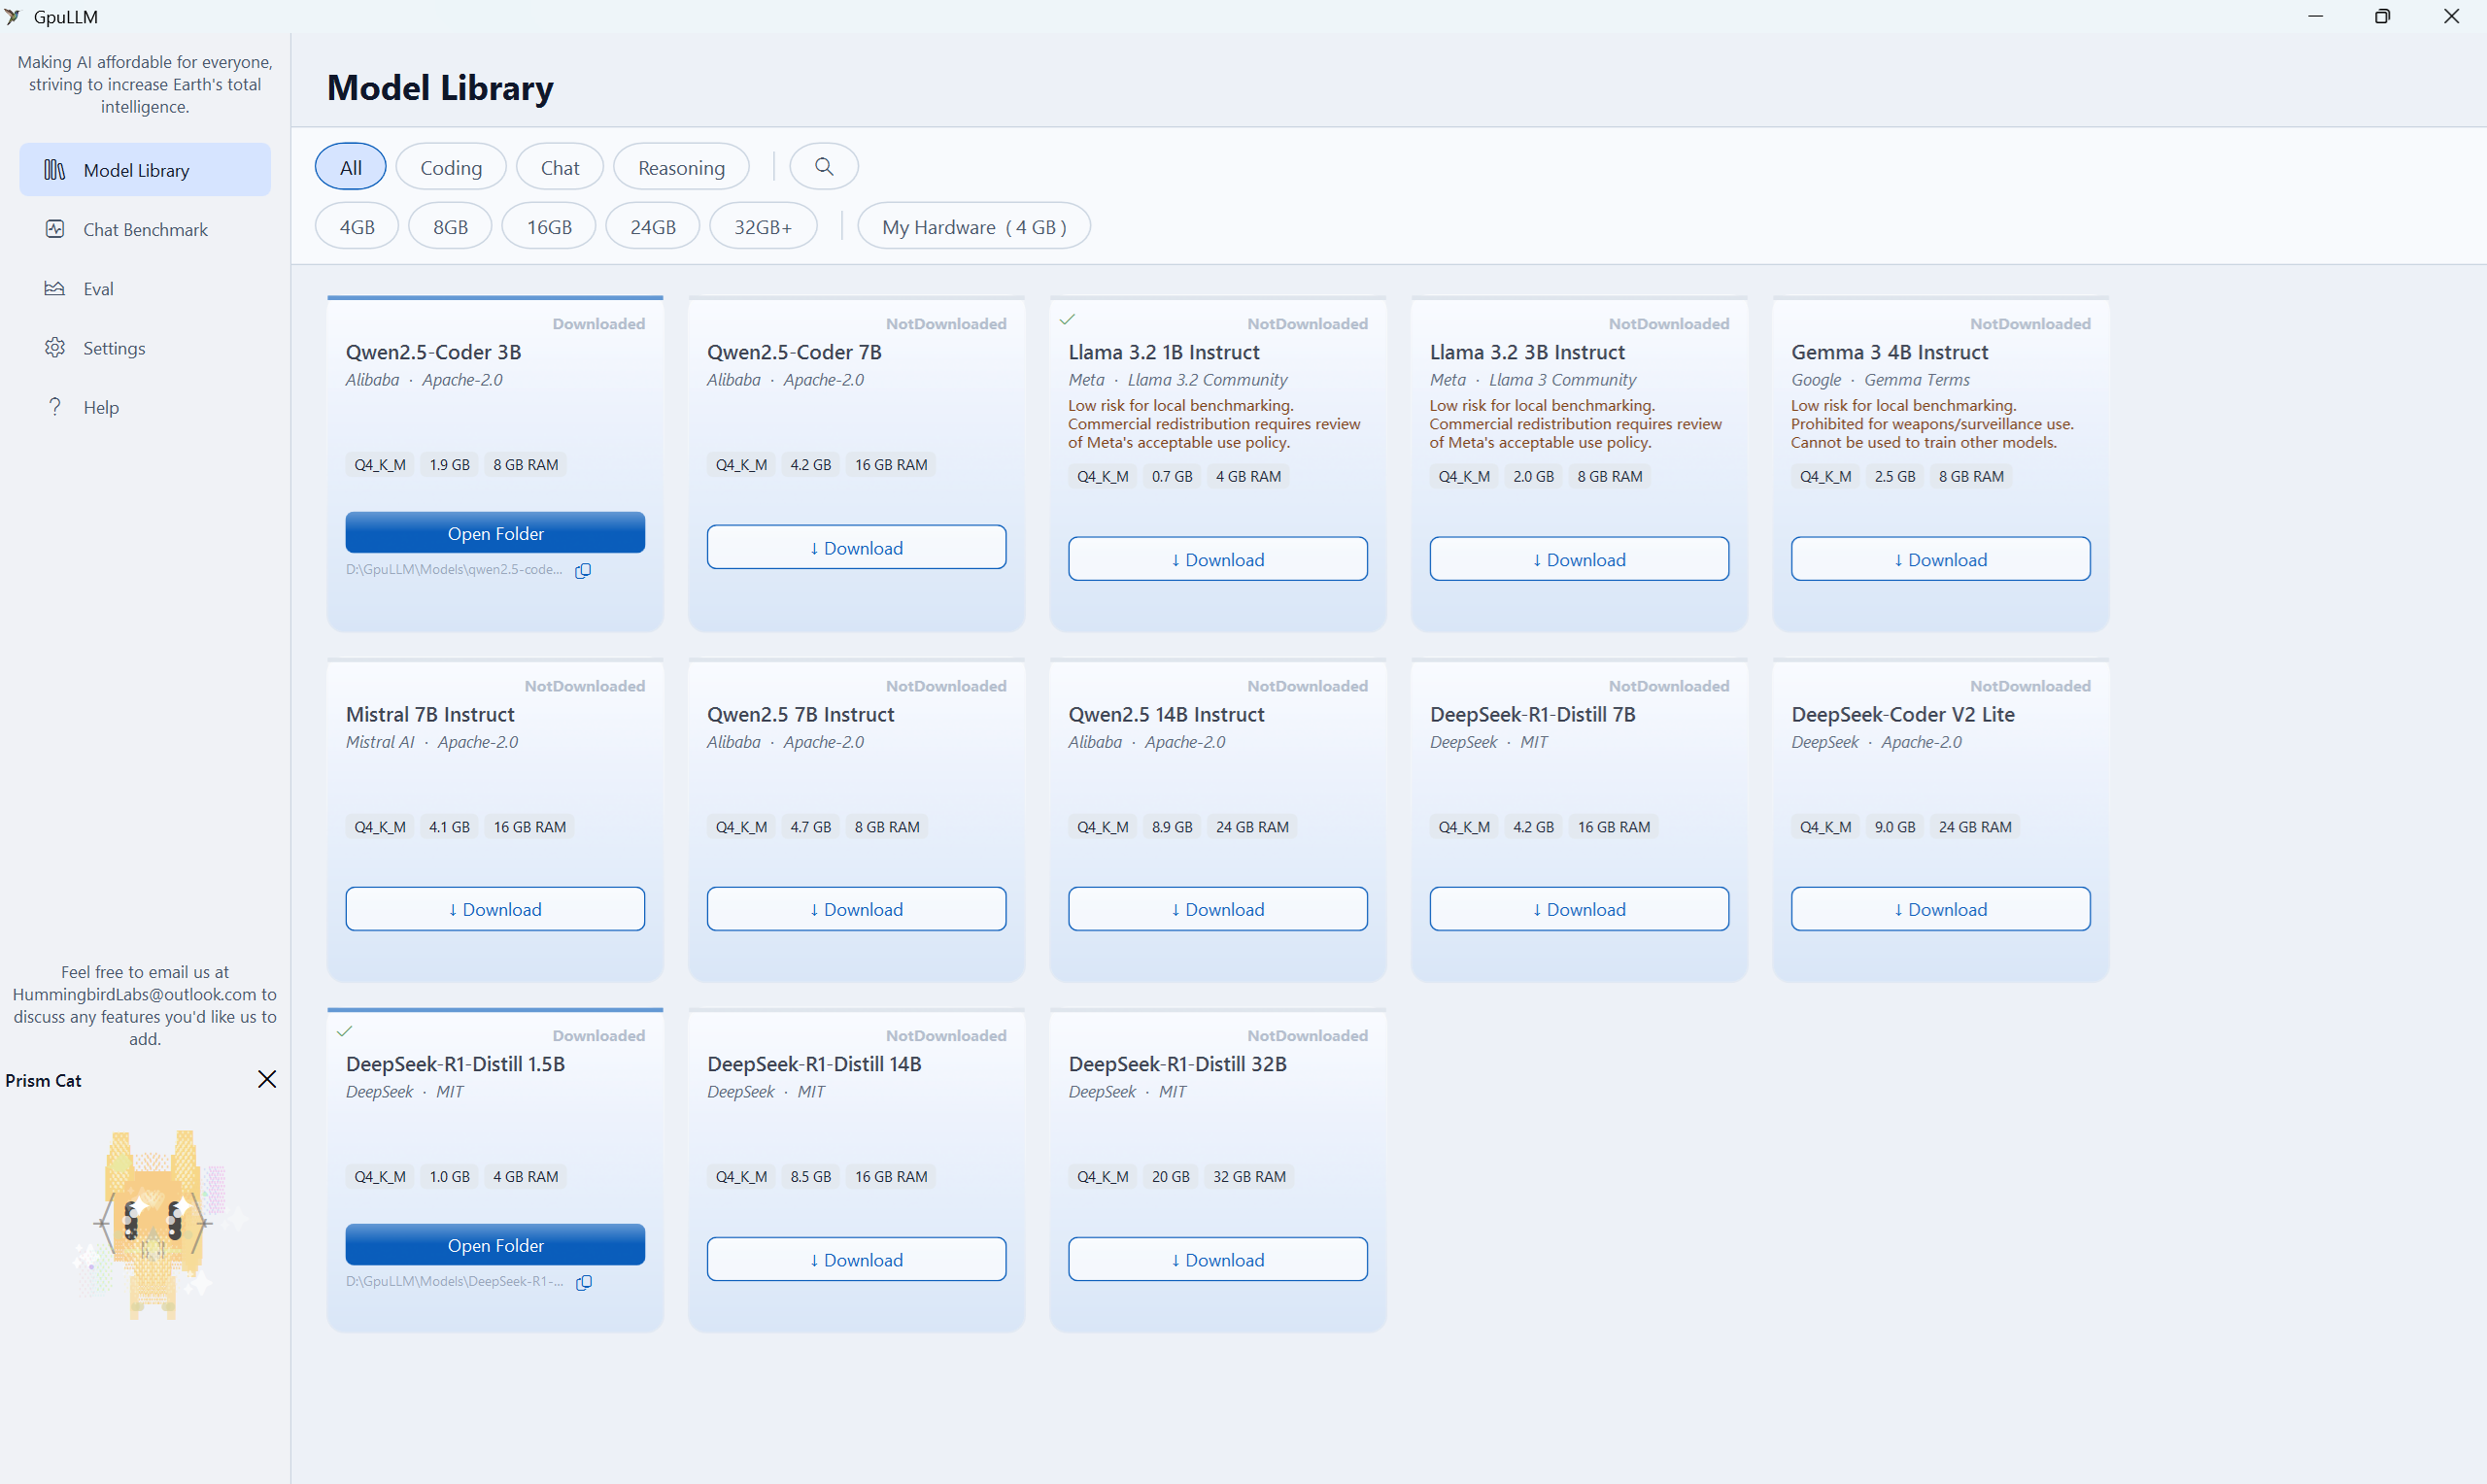
Biblioteca de modelos: explora, filtra y descarga modelos LLM seleccionados
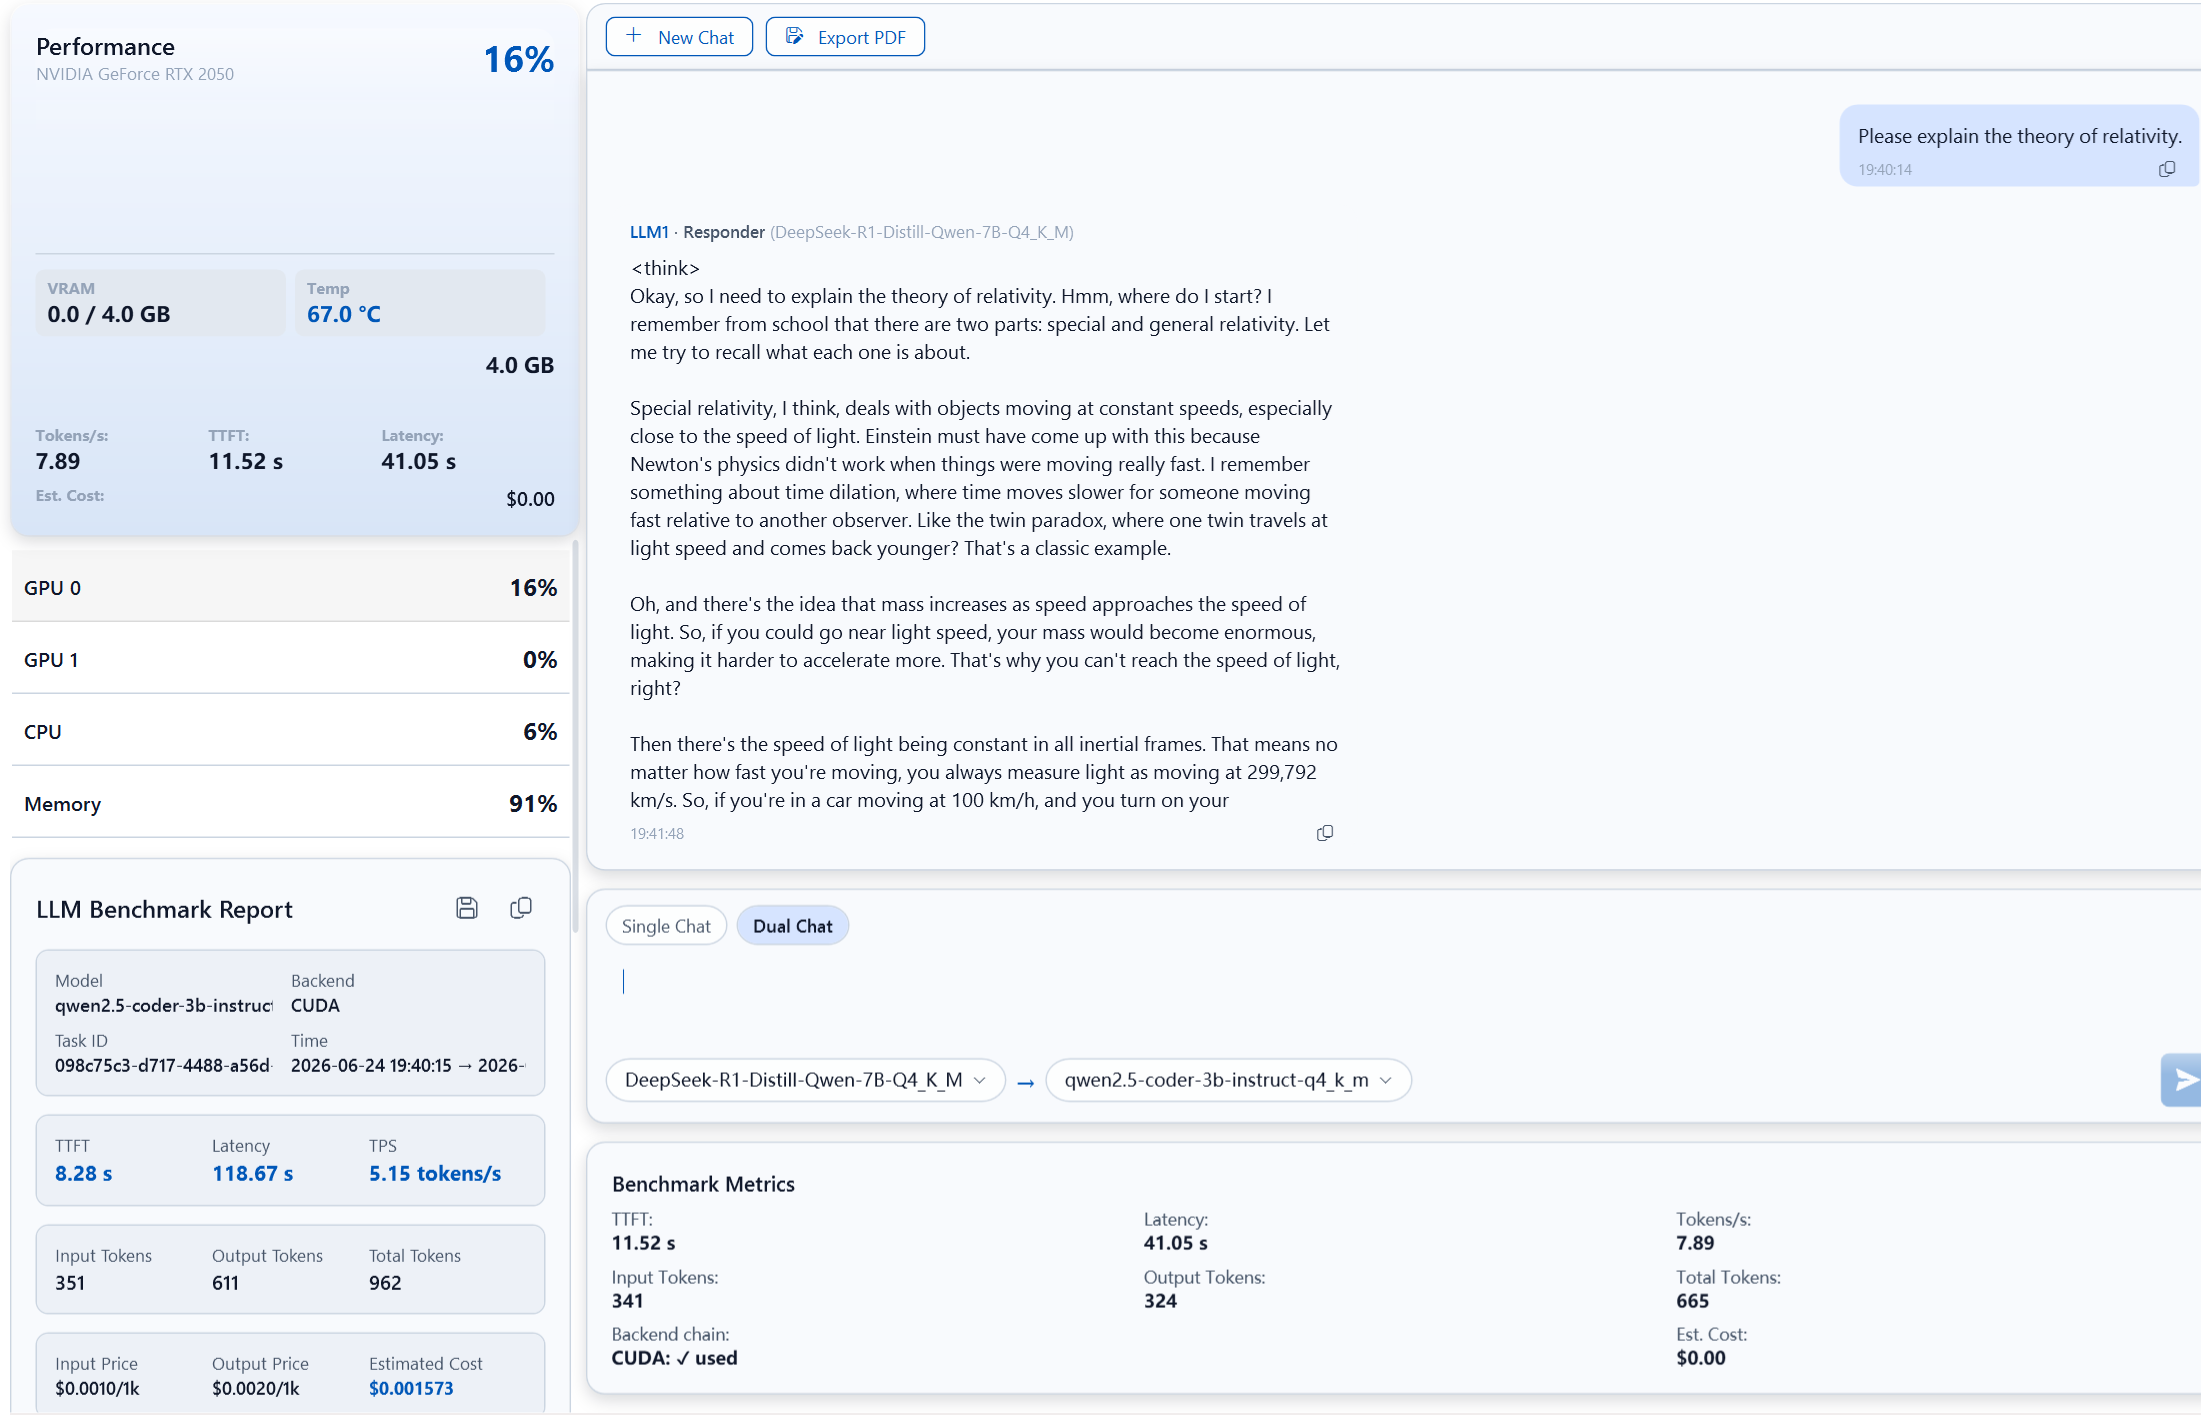
Chat benchmark: doble chat con monitorización de GPU y métricas en tiempo real
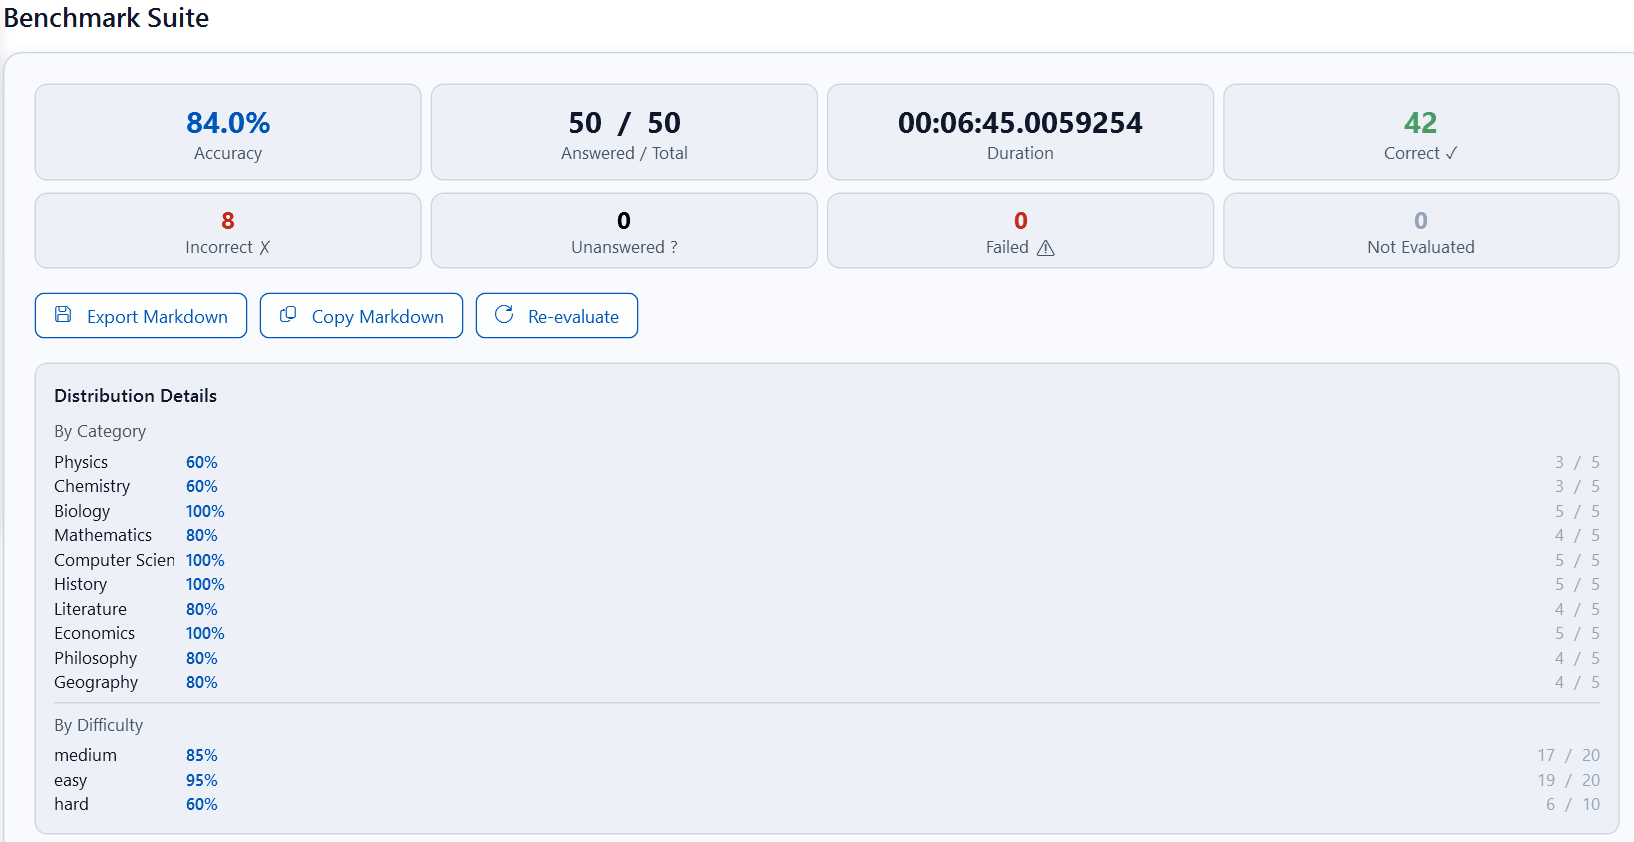
Resultados de la batería de benchmarks: precisión, distribución por categorías y desglose por dificultad
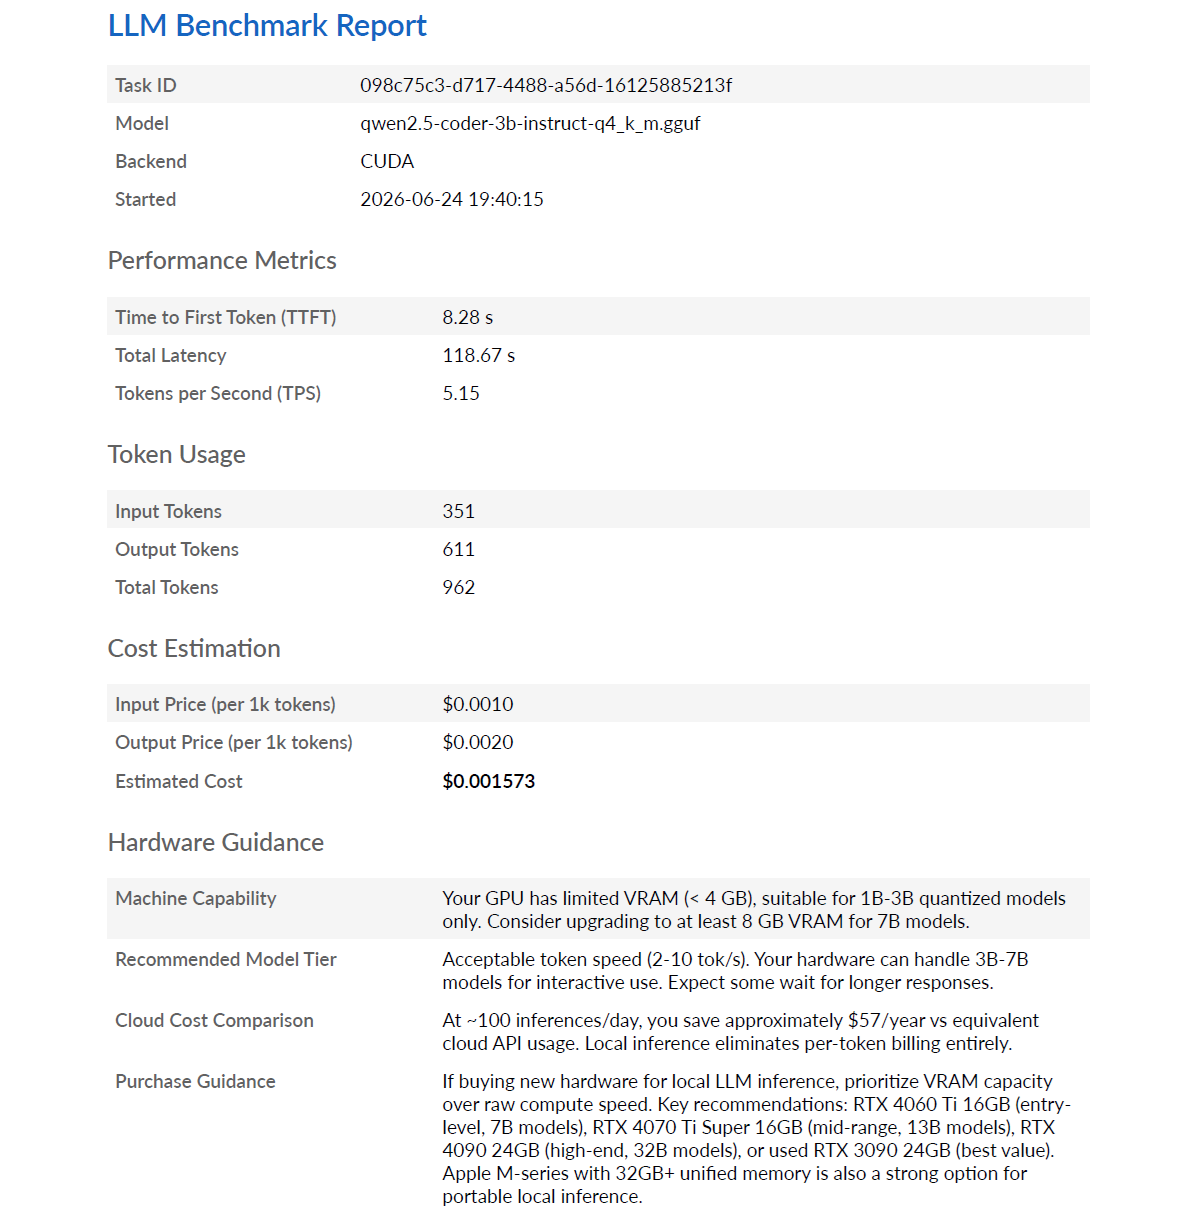
Informe de benchmark LLM: métricas de rendimiento, estimación de costes y recomendaciones de hardware

Todo lo que necesitas, y es gratis

GpuLLM es la suite gratis más completa para Windows en evaluación de LLMs locales. Esto es todo lo que incluye, sin suscripciones ni muros de pago.

Inferencia local de LLM

Ejecuta grandes modelos de lenguaje en formato GGUF directamente en tu GPU con LLamaSharp y el backend llama.cpp. Admite CUDA, Vulkan y respaldo por CPU, y selecciona automáticamente el mejor backend disponible.

Importa modelos GGUF locales

Más allá del catálogo seleccionado, importa cualquier modelo GGUF desde tu disco. Apunta GpuLLM a tus propios archivos GGUF y empieza a chatear al instante con modelos propios o de la comunidad, sin subida a la nube.

Monitorización de GPU en tiempo real

Sigue utilización de GPU, consumo de VRAM, temperatura y potencia en tiempo real. Incluye gráficos de chispa con el historial de 60 segundos y soporte multi-GPU con detección automática de dispositivos.

Chat benchmark y ahorro de costes

Chatea con cualquier modelo y mide al instante la velocidad de generación (tokens/s), el tiempo hasta el primer token y la latencia total. El estimador de costes integrado compara tu inferencia local con los precios de las API en la nube y muestra cuánto dinero ahorras.

Biblioteca y gestor de modelos

Explora 13 modelos seleccionados, entre ellos Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 y Mistral. Filtra por categoría (programación, chat o razonamiento) y comprueba la compatibilidad con tu VRAM con un clic.

Descarga desde HuggingFace

Descarga modelos directamente desde HuggingFace Hub o ModelScope. Admite descargas reanudables con verificación SHA-256, respaldo entre varias fuentes y gestión del consentimiento de licencias.

Conversación dual: respondedor y revisor

Estrena un nuevo patrón de interacción: asigna dos roles de LLM en un mismo chat, un respondedor que contesta tus preguntas y un revisor que evalúa y mejora la respuesta con sentido crítico. Este patrón de LLM como juez o debate agéntico, muy discutido en investigación en IA, permite aprovechar a la vez los puntos fuertes de dos modelos distintos para conversaciones de mayor calidad que se autocorrigen.

Animación GPU Spirit

Gato Prisma: una mascota animada que reacciona a tu nivel de utilización de GPU. Observa cómo su estado de ánimo y su color cambian en tiempo real al aumentar la carga de inferencia.

Evaluación de capacidad de modelos

Evalúa tus modelos con conjuntos completos de preguntas: 100 en inglés (MMLU, muestreadas de 57 materias) y 100 en chino (C-Eval), que cubren más de 10 dimensiones, entre ellas matemáticas, física, química, biología, informática, historia, literatura, economía, filosofía y geografía. Obtén precisión por categoría, desglose por nivel de dificultad e informes Markdown exportables.

Informe de detalles de inferencia

Cada inferencia produce un informe detallado con la cadena de backends, métricas máximas de GPU y estadísticas a nivel de token. Exporta conversaciones completas e informes como documentos PDF A4.

Qué hace diferente a GpuLLM

GpuLLM

  • ✓Chat y benchmark en una sola interfaz
  • ✓Conversación dual (respondedor + revisor)
  • ✓Evaluación de precisión MMLU y C-Eval
  • ✓Monitorización de GPU en tiempo real con gráficos de chispa
  • ✓Estimador de ahorro frente a API en la nube
  • ✓Catálogo seleccionado de 13 modelos, descarga con un clic
  • ✓100 % sin conexión, sin telemetría
  • ✓Completamente gratis, sin suscripciones

Otras herramientas

La mayoría de alternativas te dejan chatear con modelos, pero no miden el rendimiento, ni evalúan la precisión, ni siguen las métricas de GPU. Te quedas adivinando qué modelo funciona mejor en tu hardware y si de verdad ahorras frente a las API en la nube.

13 modelos preconfigurados, 3 categorías

Cada entrada incluye el repositorio correcto de HuggingFace, la cuantización y el tamaño de archivo: descarga con un clic.

Nombre mostradoCreadorCategoríaTamañoVRAM
Qwen2.5-Coder 3BAlibabaCoding1.9 GB8 GB
Qwen2.5-Coder 7BAlibabaCoding4.2 GB16 GB
DeepSeek-Coder V2 LiteDeepSeekCoding9.0 GB24 GB
Llama 3.2 1B InstructMetaChat0.7 GB4 GB
Llama 3.2 3B InstructMetaChat2.0 GB8 GB
Gemma 3 4B InstructGoogleChat2.5 GB8 GB
Mistral 7B InstructMistral AIChat4.1 GB16 GB
Qwen2.5 7B InstructAlibabaChat4.7 GB8 GB
Qwen2.5 14B InstructAlibabaChat8.9 GB24 GB
DeepSeek-R1-Distill 1.5BDeepSeekReasoning1.0 GB4 GB
DeepSeek-R1-Distill 7BDeepSeekReasoning4.2 GB16 GB
DeepSeek-R1-Distill 14BDeepSeekReasoning8.5 GB16 GB
DeepSeek-R1-Distill 32BDeepSeekReasoning20 GB32 GB

100 % sin conexión. 100 % gratis. Sin letra pequeña.

LLamaSharp / llama.cpp

Motor de inferencia C++ de alto rendimiento con enlaces gestionados para .NET, el mismo backend que usan incontables aplicaciones de IA local en todo el mundo.

WPF-UI (Fluent Design)

Interfaz moderna de escritorio para Windows con componentes Fluent Design. Temas claro y oscuro con materiales de efecto cristal y animaciones fluidas.

Respaldo entre varios backends

Cadena automática de respaldo CUDA 12 → Vulkan → CPU. La app detecta el hardware disponible y elige el backend más rápido sin configuración manual.

Privacidad desde el diseño

Toda inferencia, procesamiento de datos y operación con archivos ocurre exclusivamente en tu dispositivo local. Sin telemetría, sin dependencia de la nube y sin red una vez descargados los modelos.

Entender el benchmarking de LLMs locales

¿Qué son los tokens/s?

Los tokens por segundo miden la velocidad con la que un modelo de lenguaje genera texto. Más tokens/s significan conversaciones más ágiles. GpuLLM mide tanto el pico como el rendimiento sostenido para darte una imagen completa del comportamiento de tu GPU con LLMs.

¿Qué es el TTFT?

El tiempo hasta el primer token (TTFT) mide la latencia entre enviar una instrucción y recibir la primera palabra de la respuesta. Un TTFT bajo significa interacciones más rápidas. GpuLLM registra el TTFT para ayudarte a comparar la capacidad de respuesta de los modelos.

¿Qué es MMLU?

Massive Multitask Language Understanding (MMLU) es un benchmark estándar que evalúa conocimientos en 57 materias. GpuLLM incluye 100 preguntas muestreadas para evaluar la amplitud de conocimientos y la capacidad de razonamiento de tu modelo.

¿Qué es C-Eval?

C-Eval es un conjunto de evaluación en chino que cubre 52 disciplinas y cuatro niveles de dificultad. GpuLLM incluye 100 preguntas para evaluar la comprensión del chino y el conocimiento de dominio de tu modelo.

Preguntas frecuentes

¿GpuLLM es realmente gratis?
Sí. GpuLLM es completamente gratis, sin suscripciones, sin muros de pago y sin costes ocultos. Todas las funciones (chat, benchmark, monitorización de GPU y evaluación de modelos) están incluidas sin cargo.
¿GpuLLM funciona sin conexión?
Sí. Toda la inferencia se ejecuta 100 % en tu equipo local. Lo único que toca internet es la descarga de los modelos desde HuggingFace o ModelScope. Una vez descargados, no se necesita conexión.
¿Qué modelos puedo ejecutar con GpuLLM?
GpuLLM admite todos los modelos en formato GGUF. Incluye un catálogo seleccionado de 13 modelos, entre ellos Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 y Mistral. También puedes importar cualquier archivo GGUF desde tu disco.
¿En qué se diferencia GpuLLM de otras herramientas LLM?
La mayoría de alternativas permiten chatear, pero no miden rendimiento, ni evalúan precisión, ni monitorizan la GPU. GpuLLM es la única app gratis para Windows que combina chat, benchmark, monitorización de GPU, evaluación de modelos (MMLU/C-Eval) y estimación de costes en un solo paquete.
¿Cómo empiezo con GpuLLM?
Descarga GpuLLM en Microsoft Store, abre la biblioteca de modelos y elige uno que entre en la VRAM de tu GPU, haz clic en Descargar, después en Cargar, y empieza a chatear en Chat benchmark. Tienes una guía completa en la sección de ayuda.

GpuLLM es una aplicación de escritorio para Windows. Toda inferencia, benchmark y evaluación se ejecuta localmente en tu dispositivo. Ni los datos de los modelos ni el contenido de los chats se suben a ningún servidor. El enlace de descarga abre Microsoft Store en tu navegador predeterminado.

All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.