Application de bureau Windows

La façon la plus complète d’évaluer les performances et les capacités des LLM locaux

GpuLLM est une application Windows gratuite qui évalue en profondeur les LLM locaux, en mesurant à la fois la vitesse d’inférence (tokens/s, latence) et les capacités du modèle (scores MMLU, C-Eval). Tout est 100 % hors ligne : conversation, bancs d’essai, suivi GPU, gestion des modèles. La seule chose qui touche à Internet est le téléchargement des modèles. Trouvez en quelques minutes le modèle idéal pour votre matériel, sans dépendance cloud, sans clé API, et sans qu’aucune donnée ne quitte votre machine.

Windows 10 / 11100% Offline11 LanguagesCUDA / Vulkan / CPU

Voyez par vous-même

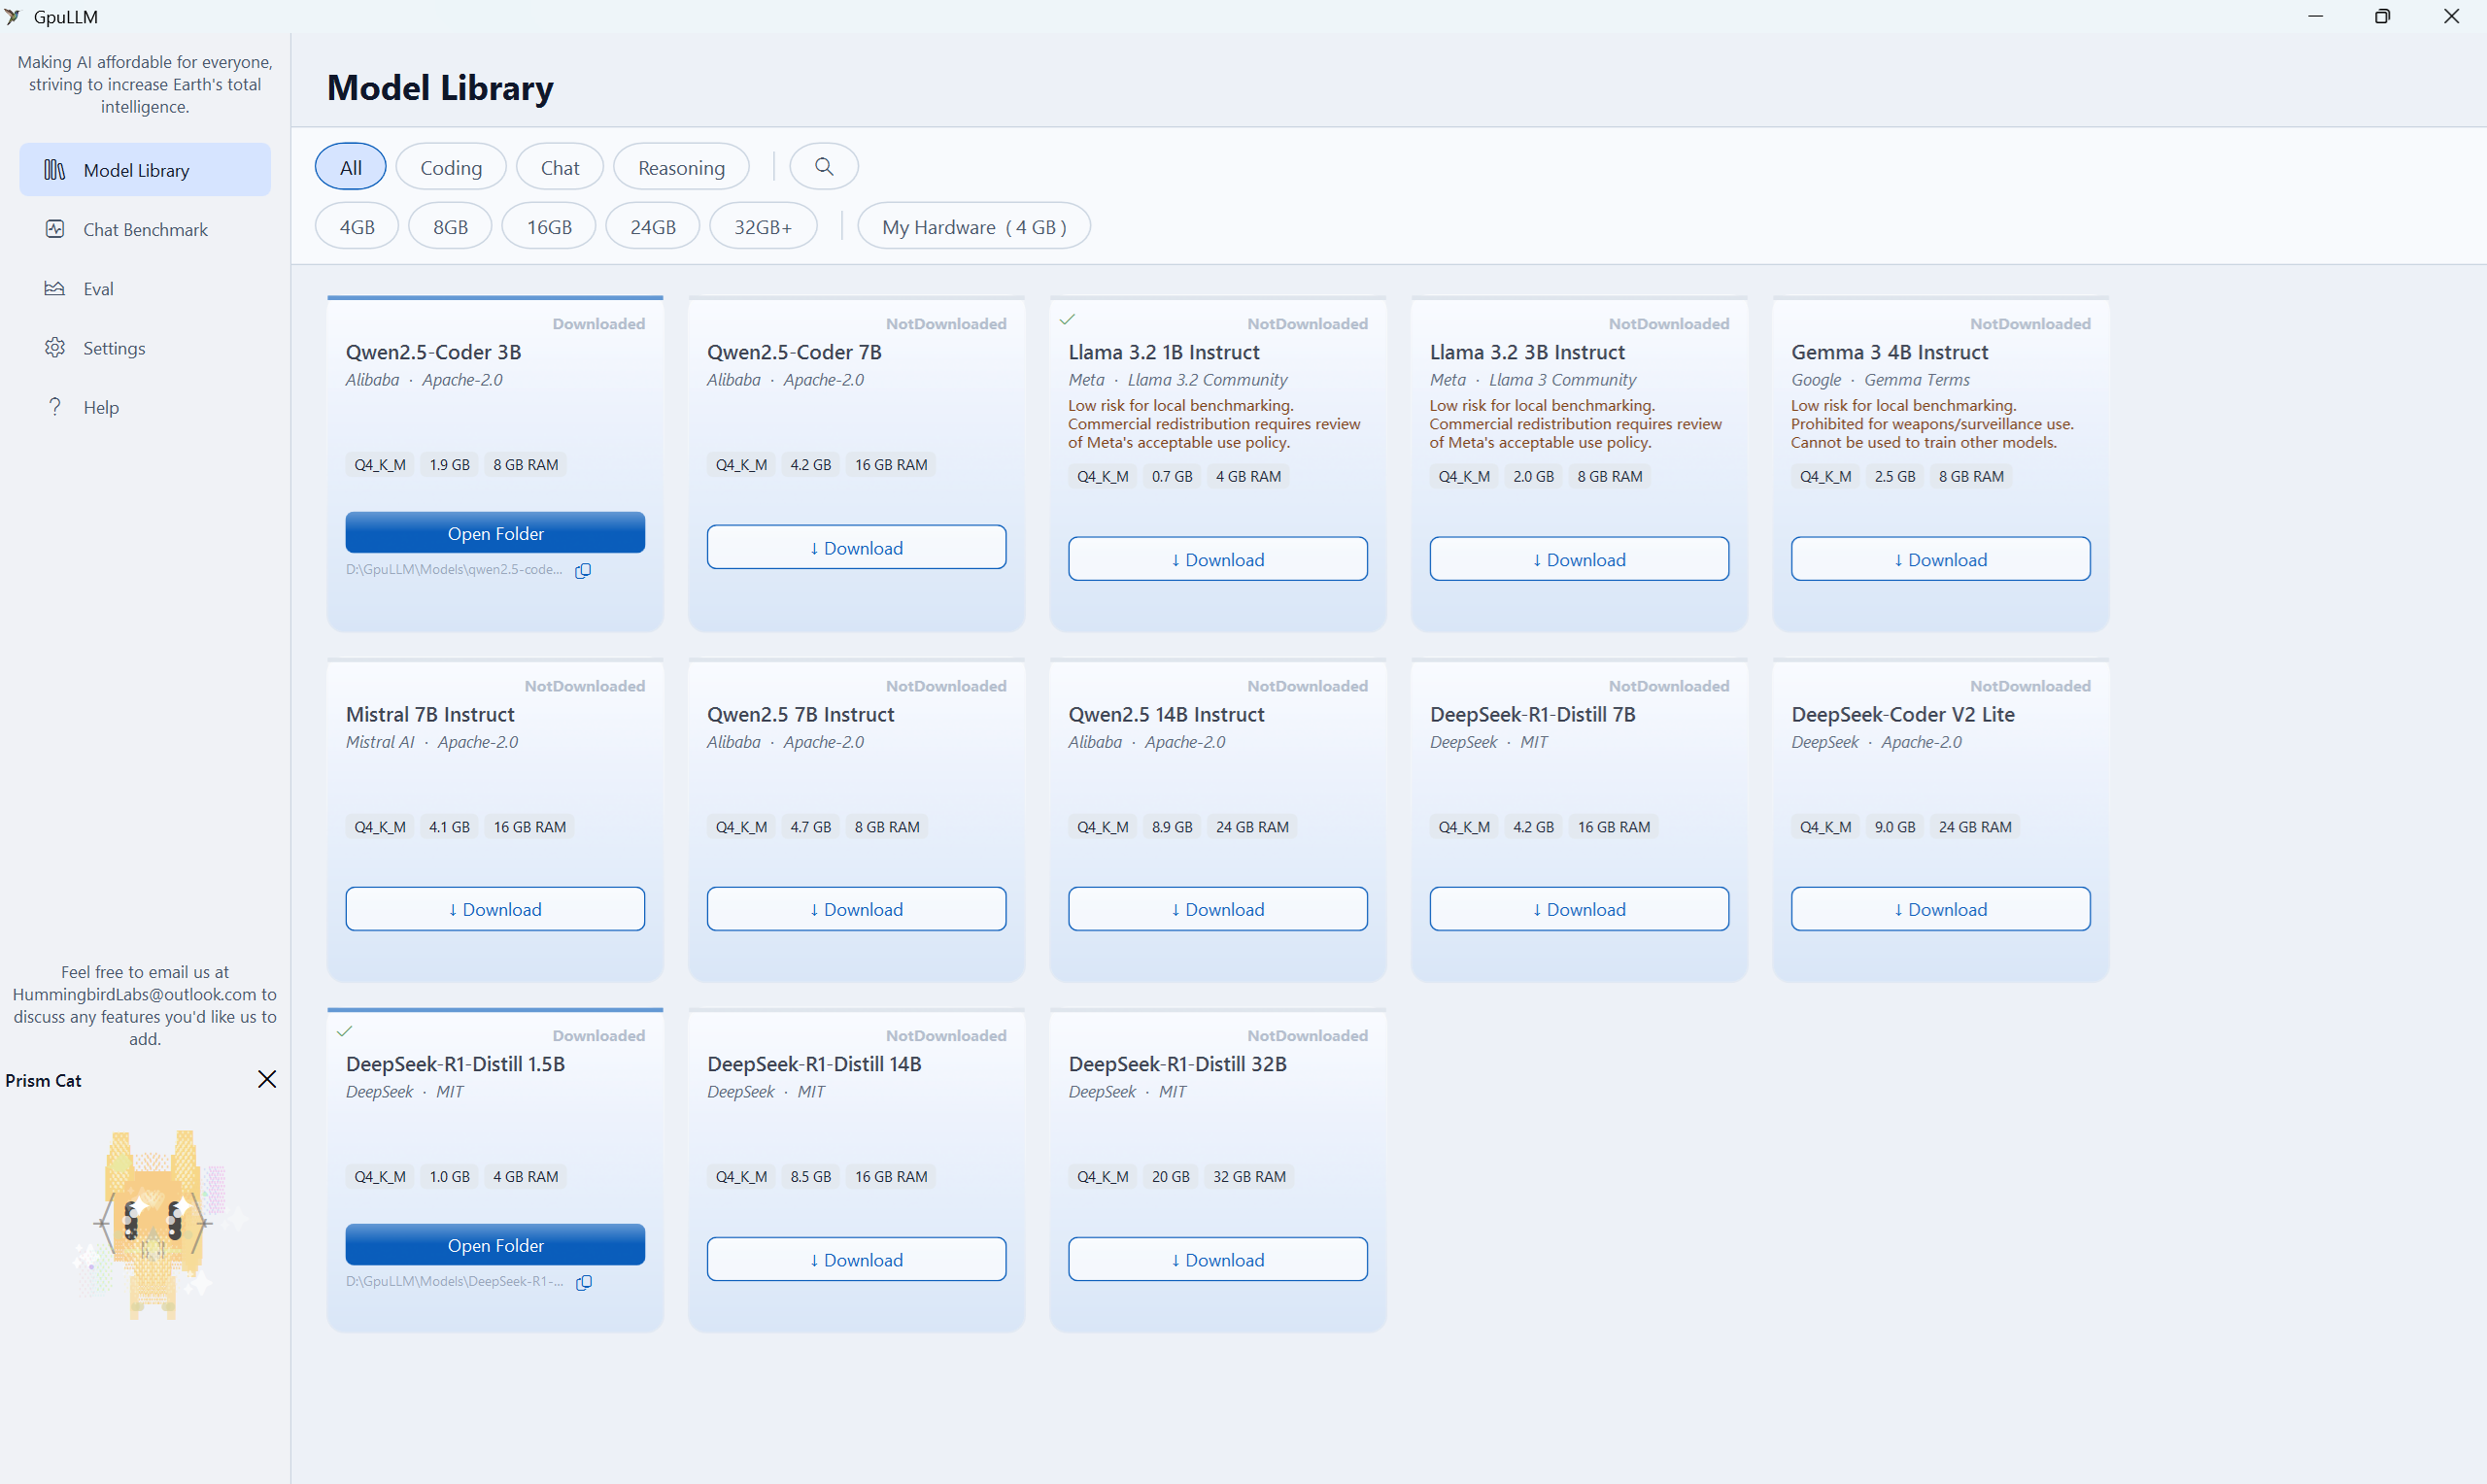
Bibliothèque de modèles : parcourez, filtrez et téléchargez une sélection de LLM
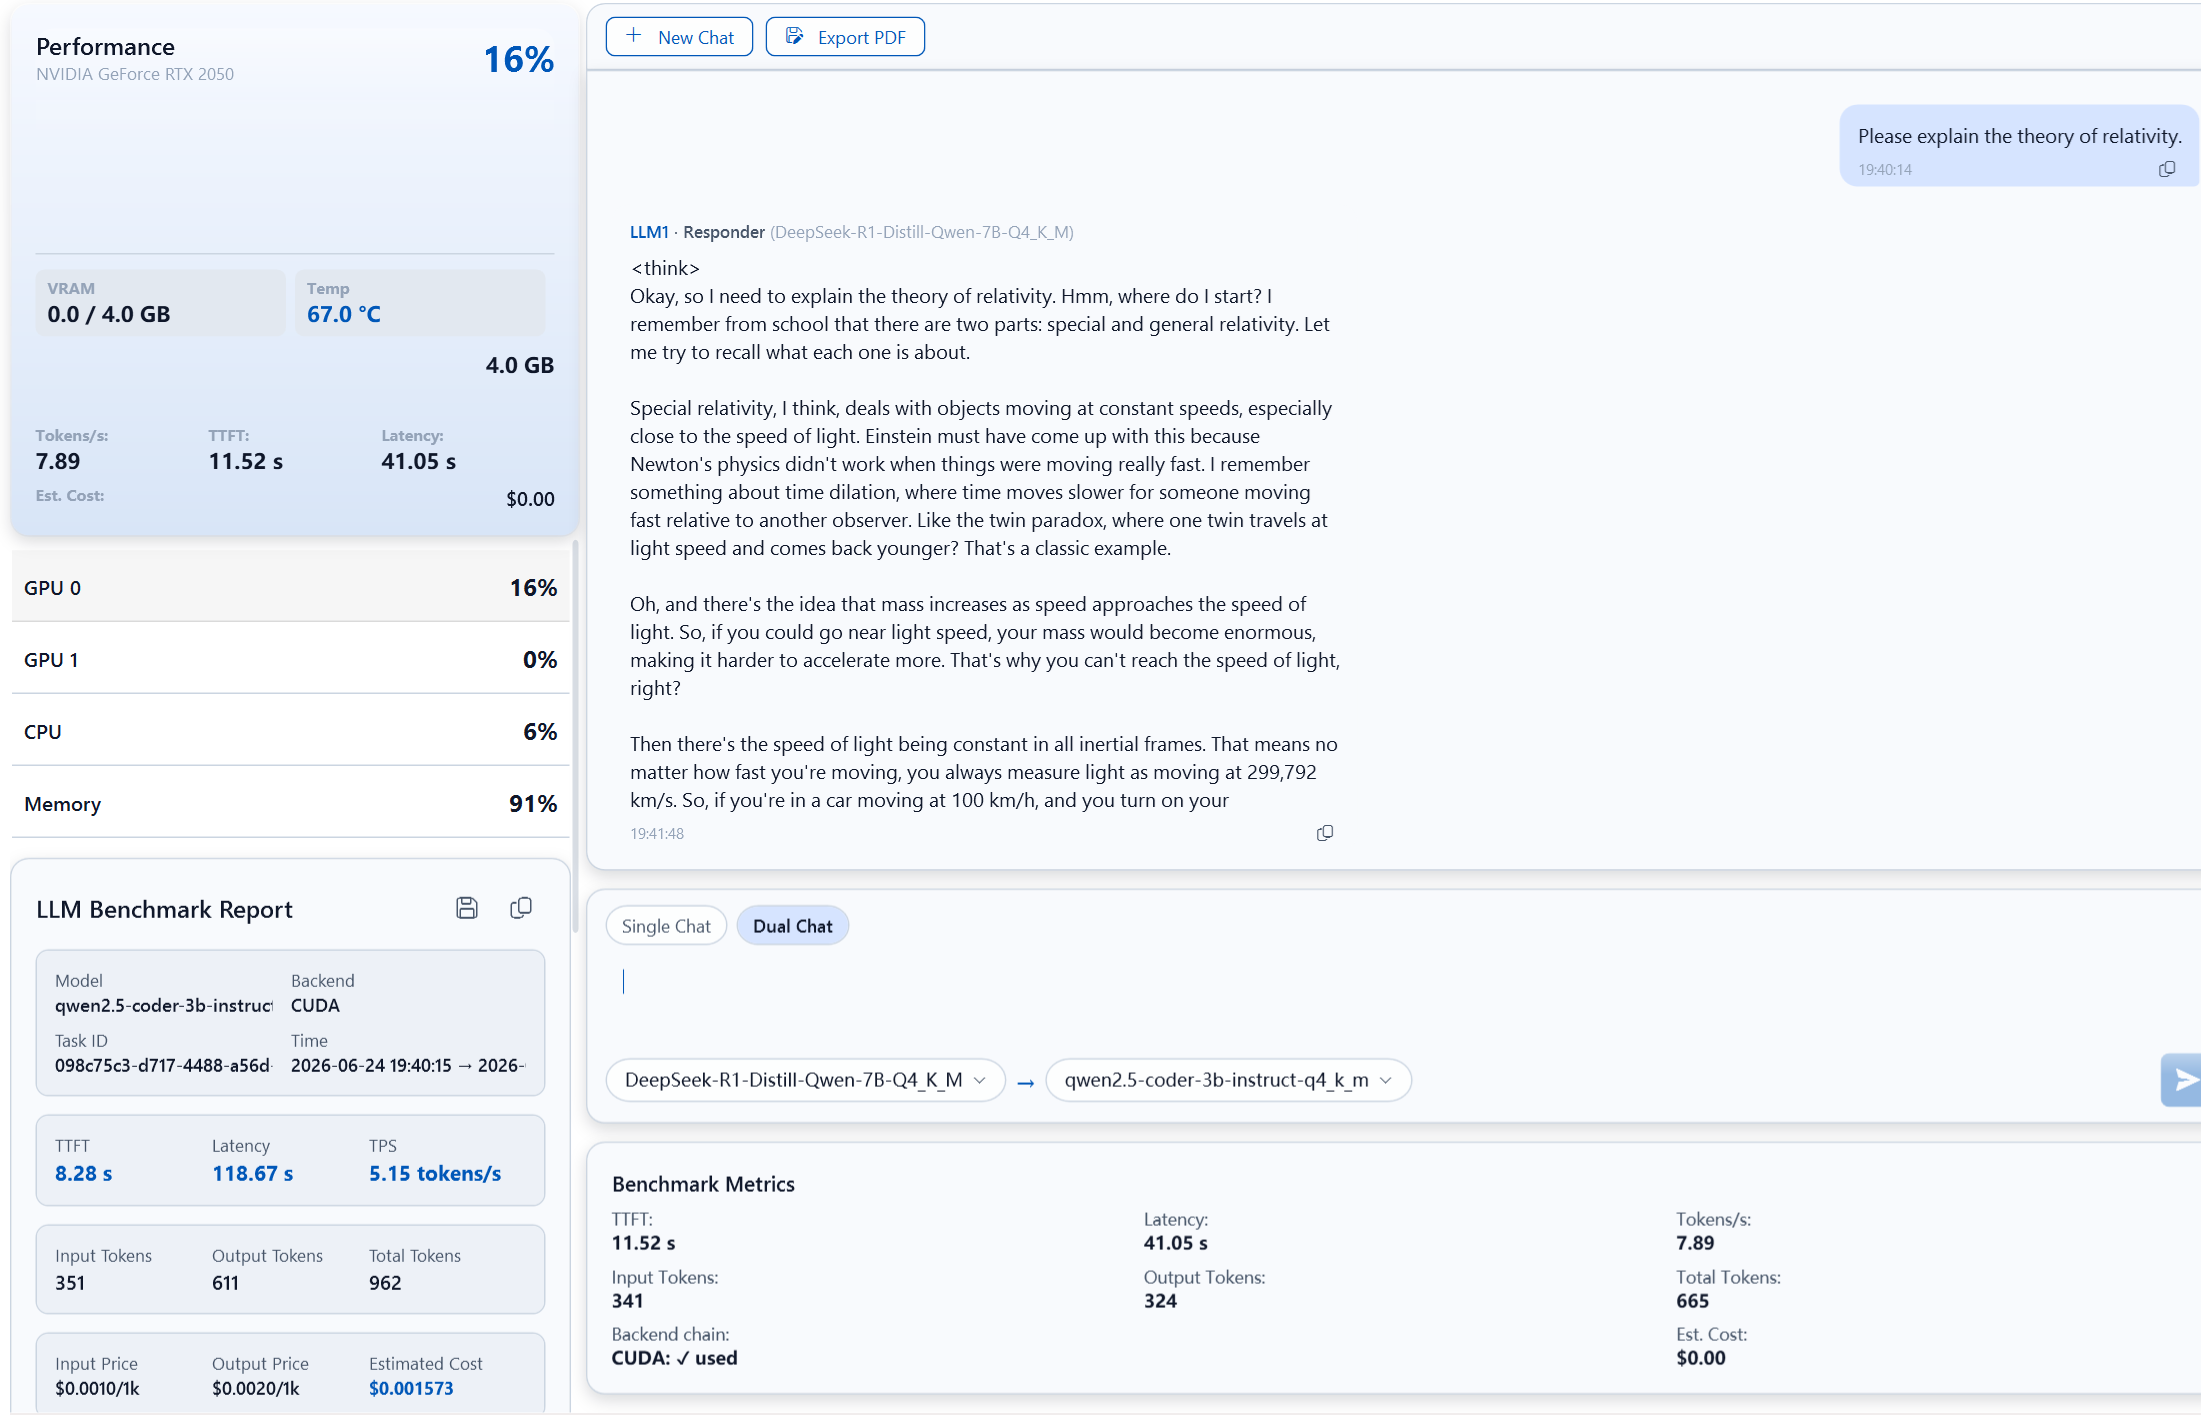
Benchmark en conversation : double chat avec suivi GPU et métriques en temps réel
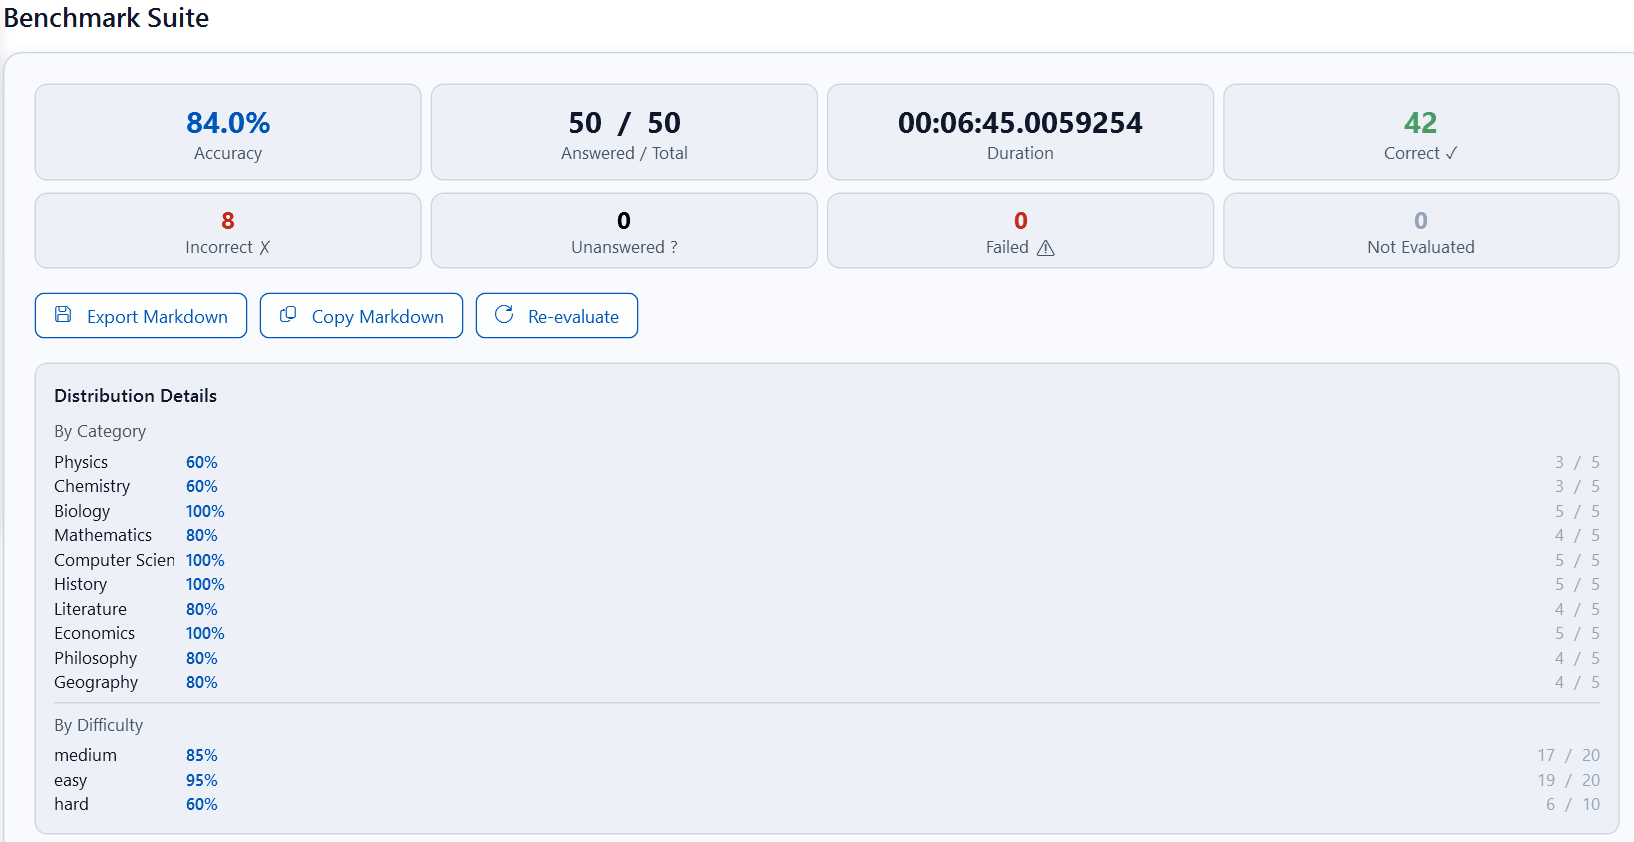
Résultats de la suite de benchmarks : score, répartition par catégorie et par difficulté
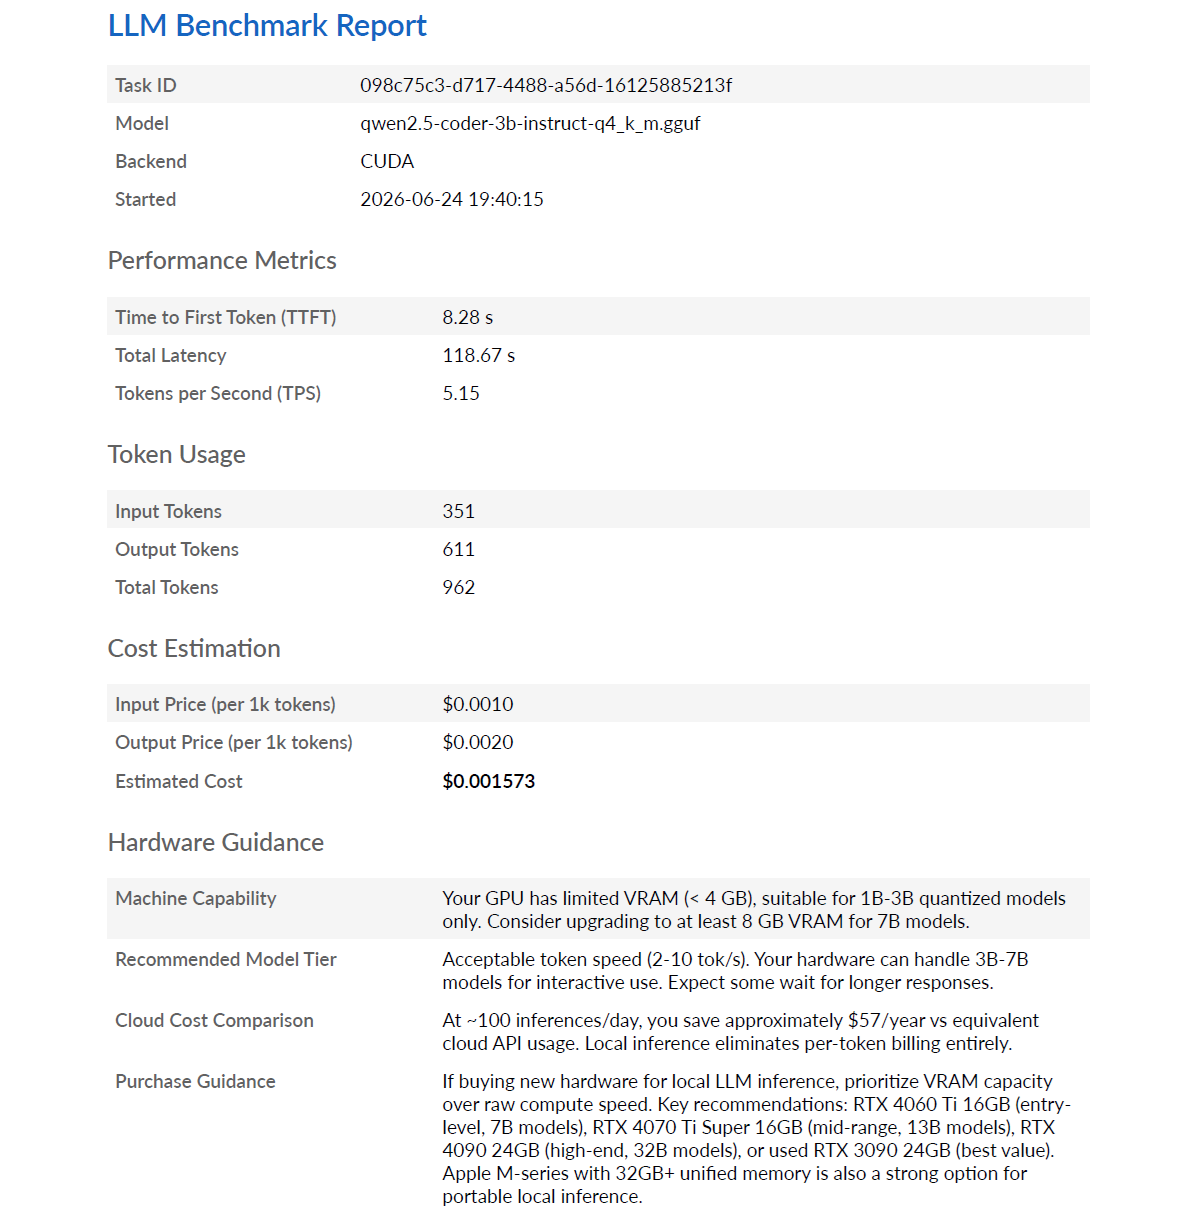
Rapport de benchmark LLM : métriques de performance, estimation des coûts et conseils matériels

Tout ce qu’il vous faut — et c’est gratuit

GpuLLM est la suite Windows gratuite la plus complète pour évaluer les LLM locaux. Voici tout ce qu’elle contient : sans abonnement, sans mur payant.

Inférence LLM locale

Exécutez des grands modèles au format GGUF directement sur votre GPU avec LLamaSharp et le backend llama.cpp. Prend en charge CUDA, Vulkan et le repli CPU, avec sélection automatique du meilleur backend.

Importez vos modèles GGUF locaux

Au-delà du catalogue sélectionné, importez n’importe quel modèle GGUF depuis votre disque. Indiquez vos propres fichiers GGUF et discutez instantanément avec des modèles personnalisés ou communautaires, sans envoi vers le cloud.

Suivi GPU en temps réel

Surveillez l’utilisation du GPU, la mémoire VRAM, la température et la consommation en temps réel. Graphiques en ligne sur 60 secondes et support multi-GPU avec détection automatique.

Benchmark en conversation & économies

Discutez avec un modèle et mesurez instantanément la vitesse de génération en tokens/s, le délai avant le premier jeton (TTFT) et la latence totale. L’estimateur de coûts intégré compare l’inférence locale aux tarifs des API cloud et montre exactement ce que vous économisez.

Bibliothèque et gestionnaire de modèles

Parcourez 13 modèles sélectionnés dont Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 et Mistral. Filtrez par catégorie — Code, Chat ou Raisonnement — et vérifiez la compatibilité VRAM en un clic.

Téléchargement HuggingFace

Téléchargez les modèles directement depuis HuggingFace Hub ou ModelScope. Reprise des téléchargements avec vérification SHA-256, repli multi-sources et gestion du consentement aux licences.

Conversation à deux modèles : répondant & critique

Un nouveau mode d’interaction : affectez deux rôles LLM dans une même conversation, un répondant qui répond à vos questions et un critique qui évalue et améliore la réponse. Ce schéma LLM-juge / débat agentique, largement étudié dans la recherche en IA, combine les forces de deux modèles pour des conversations de meilleure qualité, auto-corrigées.

Animation de l’esprit du GPU

Chat prisme : une mascotte animée qui réagit au niveau d’utilisation de votre GPU. Observez son humeur et sa couleur évoluer en temps réel à mesure que la charge d’inférence augmente.

Évaluation des capacités des modèles

Comparez vos modèles à des jeux de questions complets : 100 questions en anglais (MMLU, échantillonnées sur 57 matières) et 100 questions en chinois (C-Eval), couvrant plus de 10 dimensions : mathématiques, physique, chimie, biologie, informatique, histoire, littérature, économie, philosophie et géographie. Scores par catégorie, ventilation par difficulté et rapports Markdown exportables.

Rapport détaillé d’inférence

Chaque inférence produit un rapport détaillé avec la chaîne de backends, les pics GPU et les statistiques au niveau des jetons. Exportez les conversations complètes et les rapports en PDF A4.

Ce qui différencie GpuLLM

GpuLLM

  • ✓Chat et benchmark dans une seule interface
  • ✓Conversation à deux modèles (répondant + critique)
  • ✓Évaluation des scores MMLU & C-Eval
  • ✓Suivi GPU en temps réel avec graphiques
  • ✓Estimateur d’économies face aux API cloud
  • ✓Catalogue de 13 modèles en un clic
  • ✓100 % hors ligne, sans télémétrie
  • ✓Entièrement gratuit, sans abonnement

Autres outils

La plupart des alternatives permettent de discuter avec les modèles, mais sans mesurer les performances, évaluer les scores ni suivre le GPU. Vous devez deviner quel modèle fonctionne le mieux sur votre matériel et si vous faites réellement des économies par rapport aux API cloud.

13 modèles préconfigurés, 3 catégories

Chaque entrée contient le bon dépôt HuggingFace, la quantification et la taille du fichier : téléchargement en un clic.

Nom affichéCréateurCatégorieTailleVRAM
Qwen2.5-Coder 3BAlibabaCoding1.9 GB8 GB
Qwen2.5-Coder 7BAlibabaCoding4.2 GB16 GB
DeepSeek-Coder V2 LiteDeepSeekCoding9.0 GB24 GB
Llama 3.2 1B InstructMetaChat0.7 GB4 GB
Llama 3.2 3B InstructMetaChat2.0 GB8 GB
Gemma 3 4B InstructGoogleChat2.5 GB8 GB
Mistral 7B InstructMistral AIChat4.1 GB16 GB
Qwen2.5 7B InstructAlibabaChat4.7 GB8 GB
Qwen2.5 14B InstructAlibabaChat8.9 GB24 GB
DeepSeek-R1-Distill 1.5BDeepSeekReasoning1.0 GB4 GB
DeepSeek-R1-Distill 7BDeepSeekReasoning4.2 GB16 GB
DeepSeek-R1-Distill 14BDeepSeekReasoning8.5 GB16 GB
DeepSeek-R1-Distill 32BDeepSeekReasoning20 GB32 GB

100 % hors ligne. 100 % gratuit. Sans contrepartie.

LLamaSharp / llama.cpp

Moteur d’inférence C++ haute performance avec bindings .NET managés : le même backend qui fait tourner d’innombrables applications d’IA locale dans le monde.

WPF-UI (Fluent Design)

Interface Windows moderne avec les composants du Fluent Design System. Thèmes sombre et clair avec effets de verre et animations fluides.

Repli multi-backends

Chaîne de repli automatique CUDA 12 → Vulkan → CPU. L’application détecte le matériel disponible et choisit le backend le plus rapide sans configuration manuelle.

Confidentialité dès la conception

Toute l’inférence, le traitement des données et les opérations sur les fichiers ont lieu exclusivement sur votre appareil. Pas de télémétrie, pas de dépendance cloud, pas de réseau une fois les modèles téléchargés.

Comprendre les bancs d’essai de LLM locaux

Que sont les tokens/s ?

Les jetons par seconde mesurent la vitesse à laquelle un modèle génère du texte. Plus de tokens/s, c’est une conversation plus réactive. GpuLLM mesure à la fois le débit de pointe et le débit soutenu pour une image complète des performances LLM de votre GPU.

Qu’est-ce que le TTFT ?

Le délai avant le premier jeton (TTFT) mesure la latence entre l’envoi d’une requête et la réception du premier mot de la réponse. Un TTFT faible, c’est une interaction plus vive. GpuLLM suit le TTFT pour vous aider à comparer la réactivité des modèles.

Qu’est-ce que le MMLU ?

Massive Multitask Language Understanding (MMLU) est un benchmark standard évaluant les connaissances dans 57 matières. GpuLLM inclut 100 questions échantillonnées pour évaluer l’étendue des connaissances et le raisonnement de votre modèle.

Qu’est-ce que le C-Eval ?

C-Eval est une suite d’évaluation chinoise couvrant 52 disciplines et quatre niveaux de difficulté. GpuLLM inclut 100 questions pour tester la compréhension du chinois et les connaissances métiers de votre modèle.

Questions fréquentes

GpuLLM est-il vraiment gratuit ?
Oui. GpuLLM est entièrement gratuit, sans abonnement, sans mur payant ni coût caché. Toutes les fonctions — conversation, benchmark, suivi GPU et évaluation de modèles — sont incluses sans frais.
GpuLLM fonctionne-t-il hors ligne ?
Oui. Toute l’inférence s’exécute à 100 % sur votre machine. La seule chose qui touche à Internet est le téléchargement des modèles depuis HuggingFace ou ModelScope. Une fois téléchargés, aucune connexion n’est nécessaire.
Quels modèles puis-je exécuter avec GpuLLM ?
GpuLLM prend en charge tous les modèles au format GGUF. Il propose un catalogue de 13 modèles dont Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 et Mistral. Vous pouvez aussi importer n’importe quel fichier GGUF depuis votre disque.
En quoi GpuLLM diffère-t-il des autres outils LLM ?
La plupart des alternatives permettent de discuter sans mesurer les performances, les scores ou le GPU. GpuLLM est la seule application Windows gratuite qui réunit conversation, benchmark, suivi GPU, évaluation MMLU/C-Eval et estimation des coûts en un seul outil.
Comment démarrer avec GpuLLM ?
Téléchargez GpuLLM sur le Microsoft Store, parcourez la bibliothèque de modèles pour choisir un modèle adapté à la VRAM de votre GPU, cliquez sur Télécharger puis Charger, et lancez la conversation dans le benchmark en chat. Le guide complet se trouve dans la section Aide.

GpuLLM est une application de bureau Windows. Toutes les inférences, benchmarks et évaluations s’exécutent localement sur votre appareil. Aucune donnée de modèle ni contenu de conversation n’est envoyé à un serveur. Le lien de téléchargement ouvre le Microsoft Store dans votre navigateur par défaut.

All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.