Aplicativo de desktop para Windows

A forma mais completa de avaliar o desempenho e a capacidade de LLMs locais

O GpuLLM é um aplicativo grátis para Windows que permite avaliar a fundo LLMs locais — medindo tanto a velocidade de inferência (tokens/s, latência) quanto a capacidade do modelo (precisão MMLU, C-Eval). Tudo é 100% offline — chat, benchmark, monitoramento de GPU e gerenciamento de modelos — a única coisa que acessa a internet é o download dos modelos. Encontre a combinação ideal de modelo e hardware em minutos, não em horas. Sem dependência da nuvem, sem chaves de API e sem que seus dados saiam da sua máquina.

Windows 10 / 11100% Offline11 LanguagesCUDA / Vulkan / CPU

Veja você mesmo

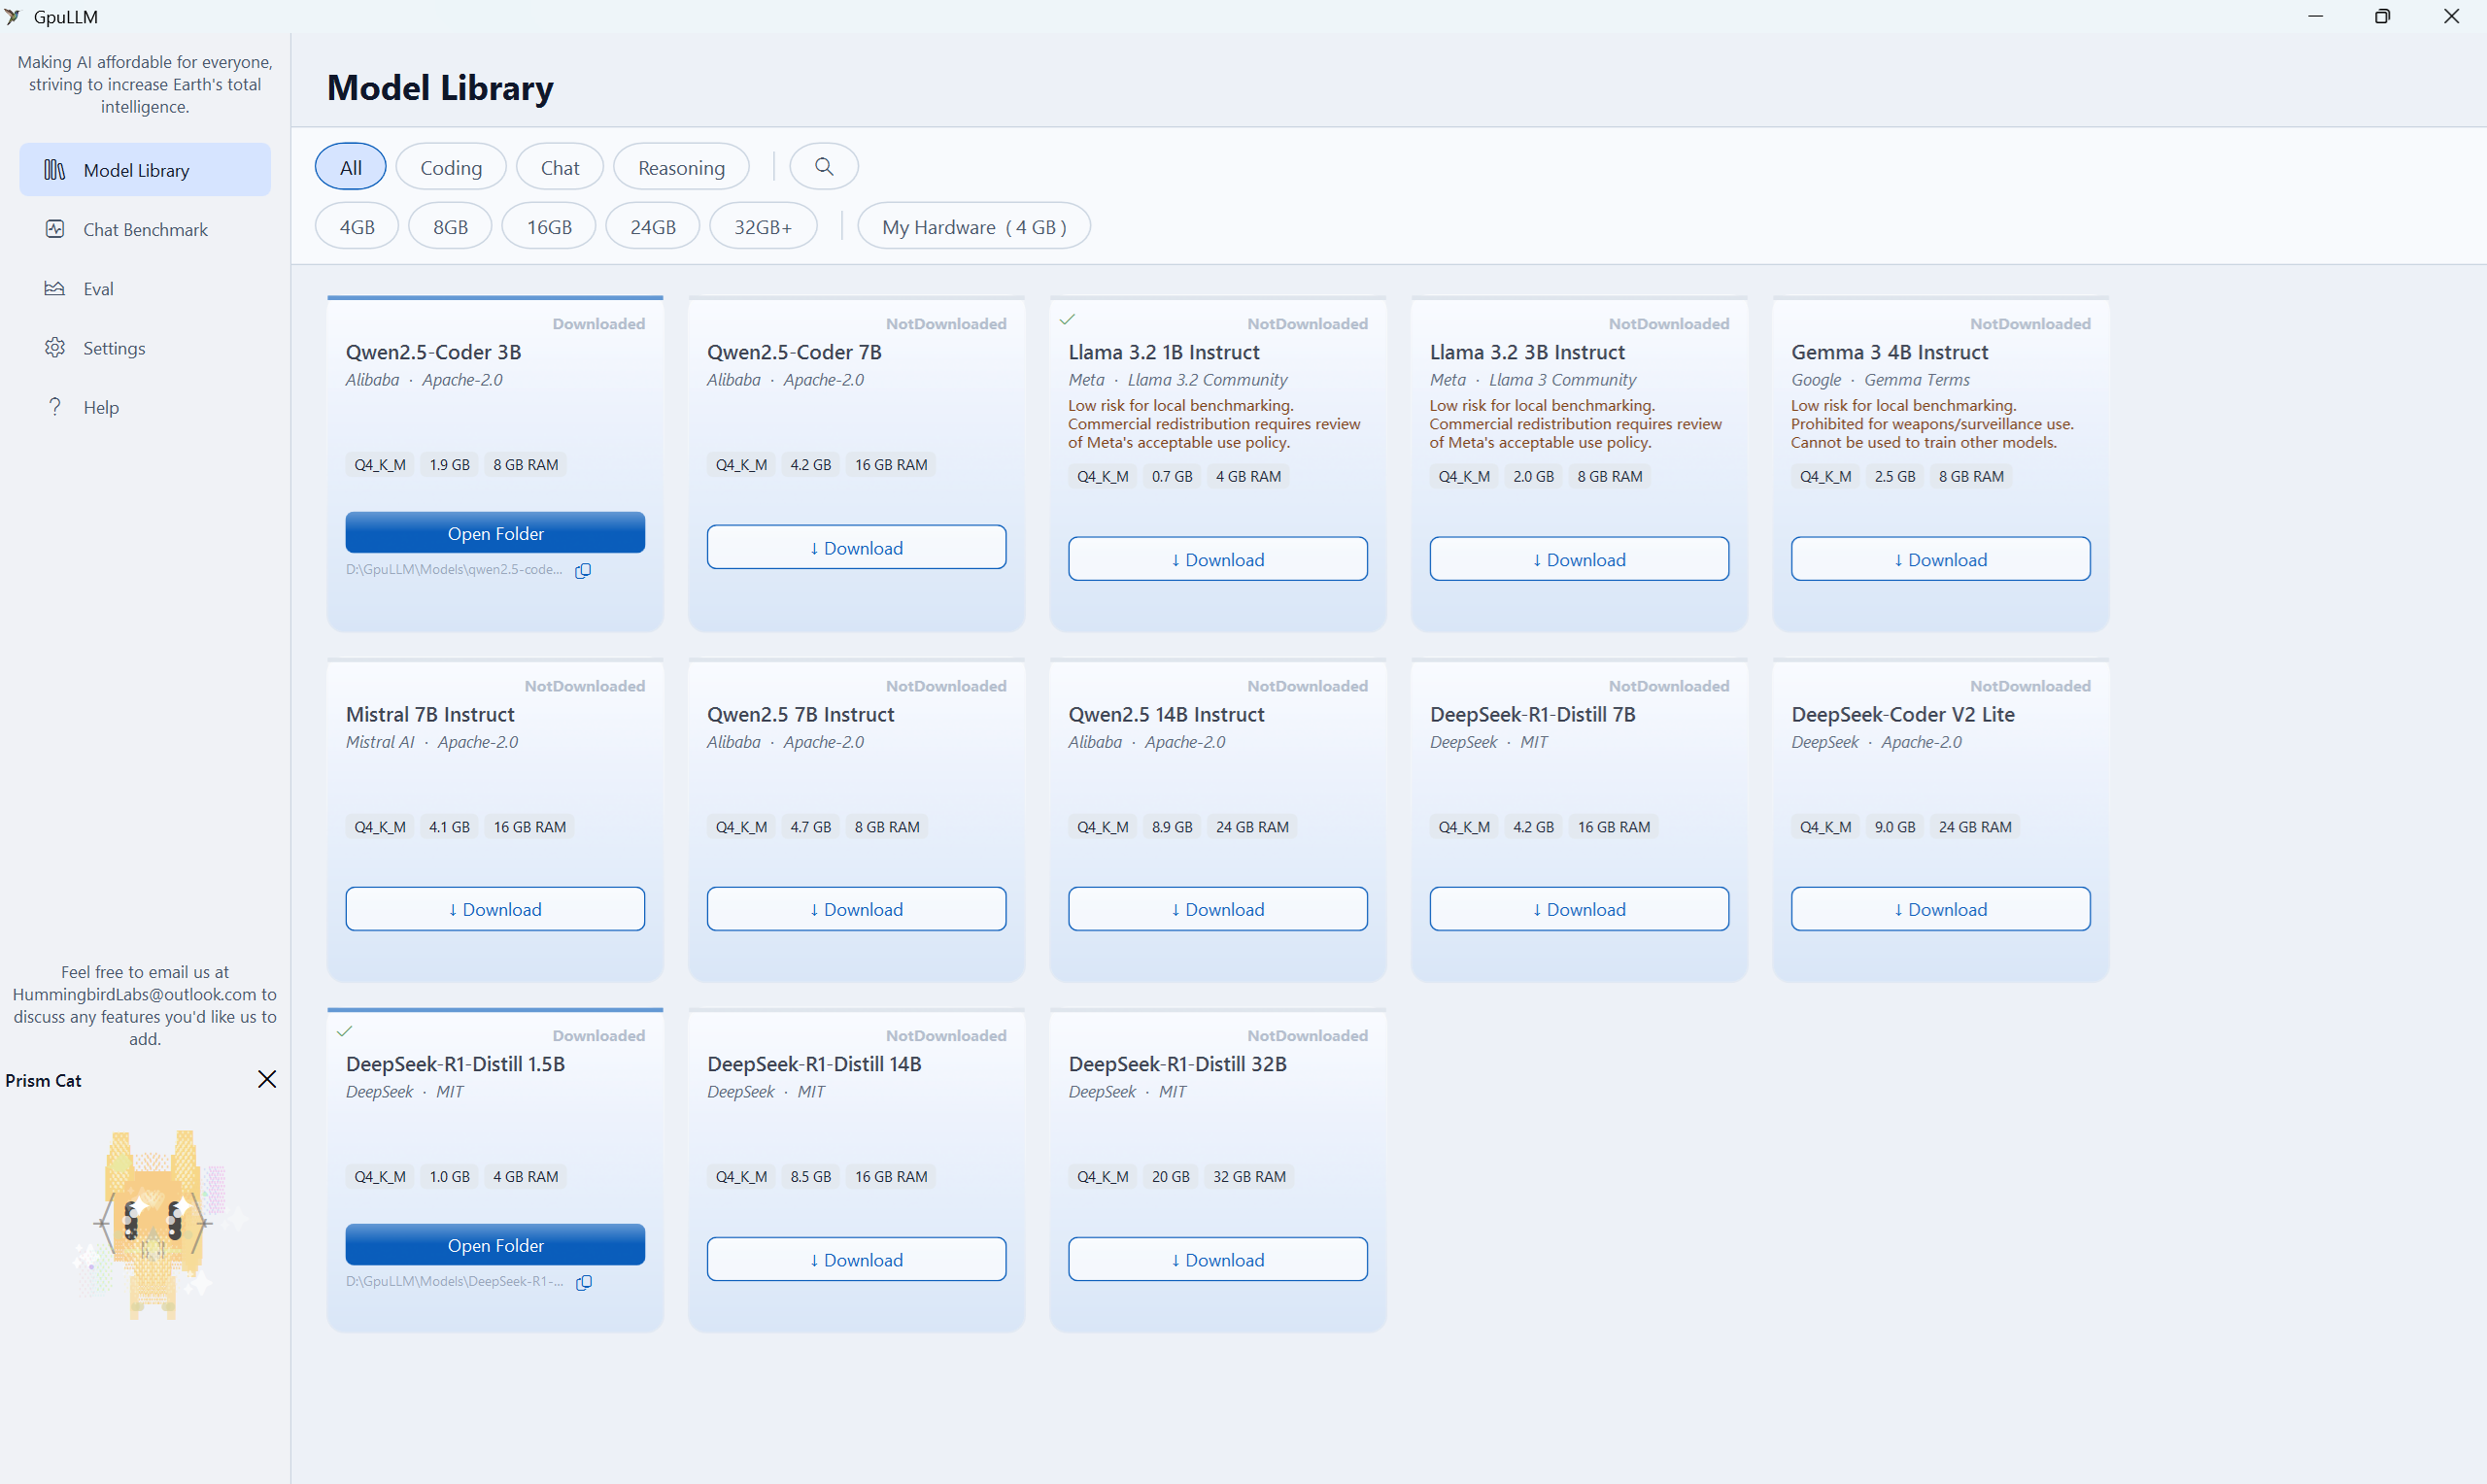
Biblioteca de modelos — explore, filtre e baixe modelos LLM selecionados
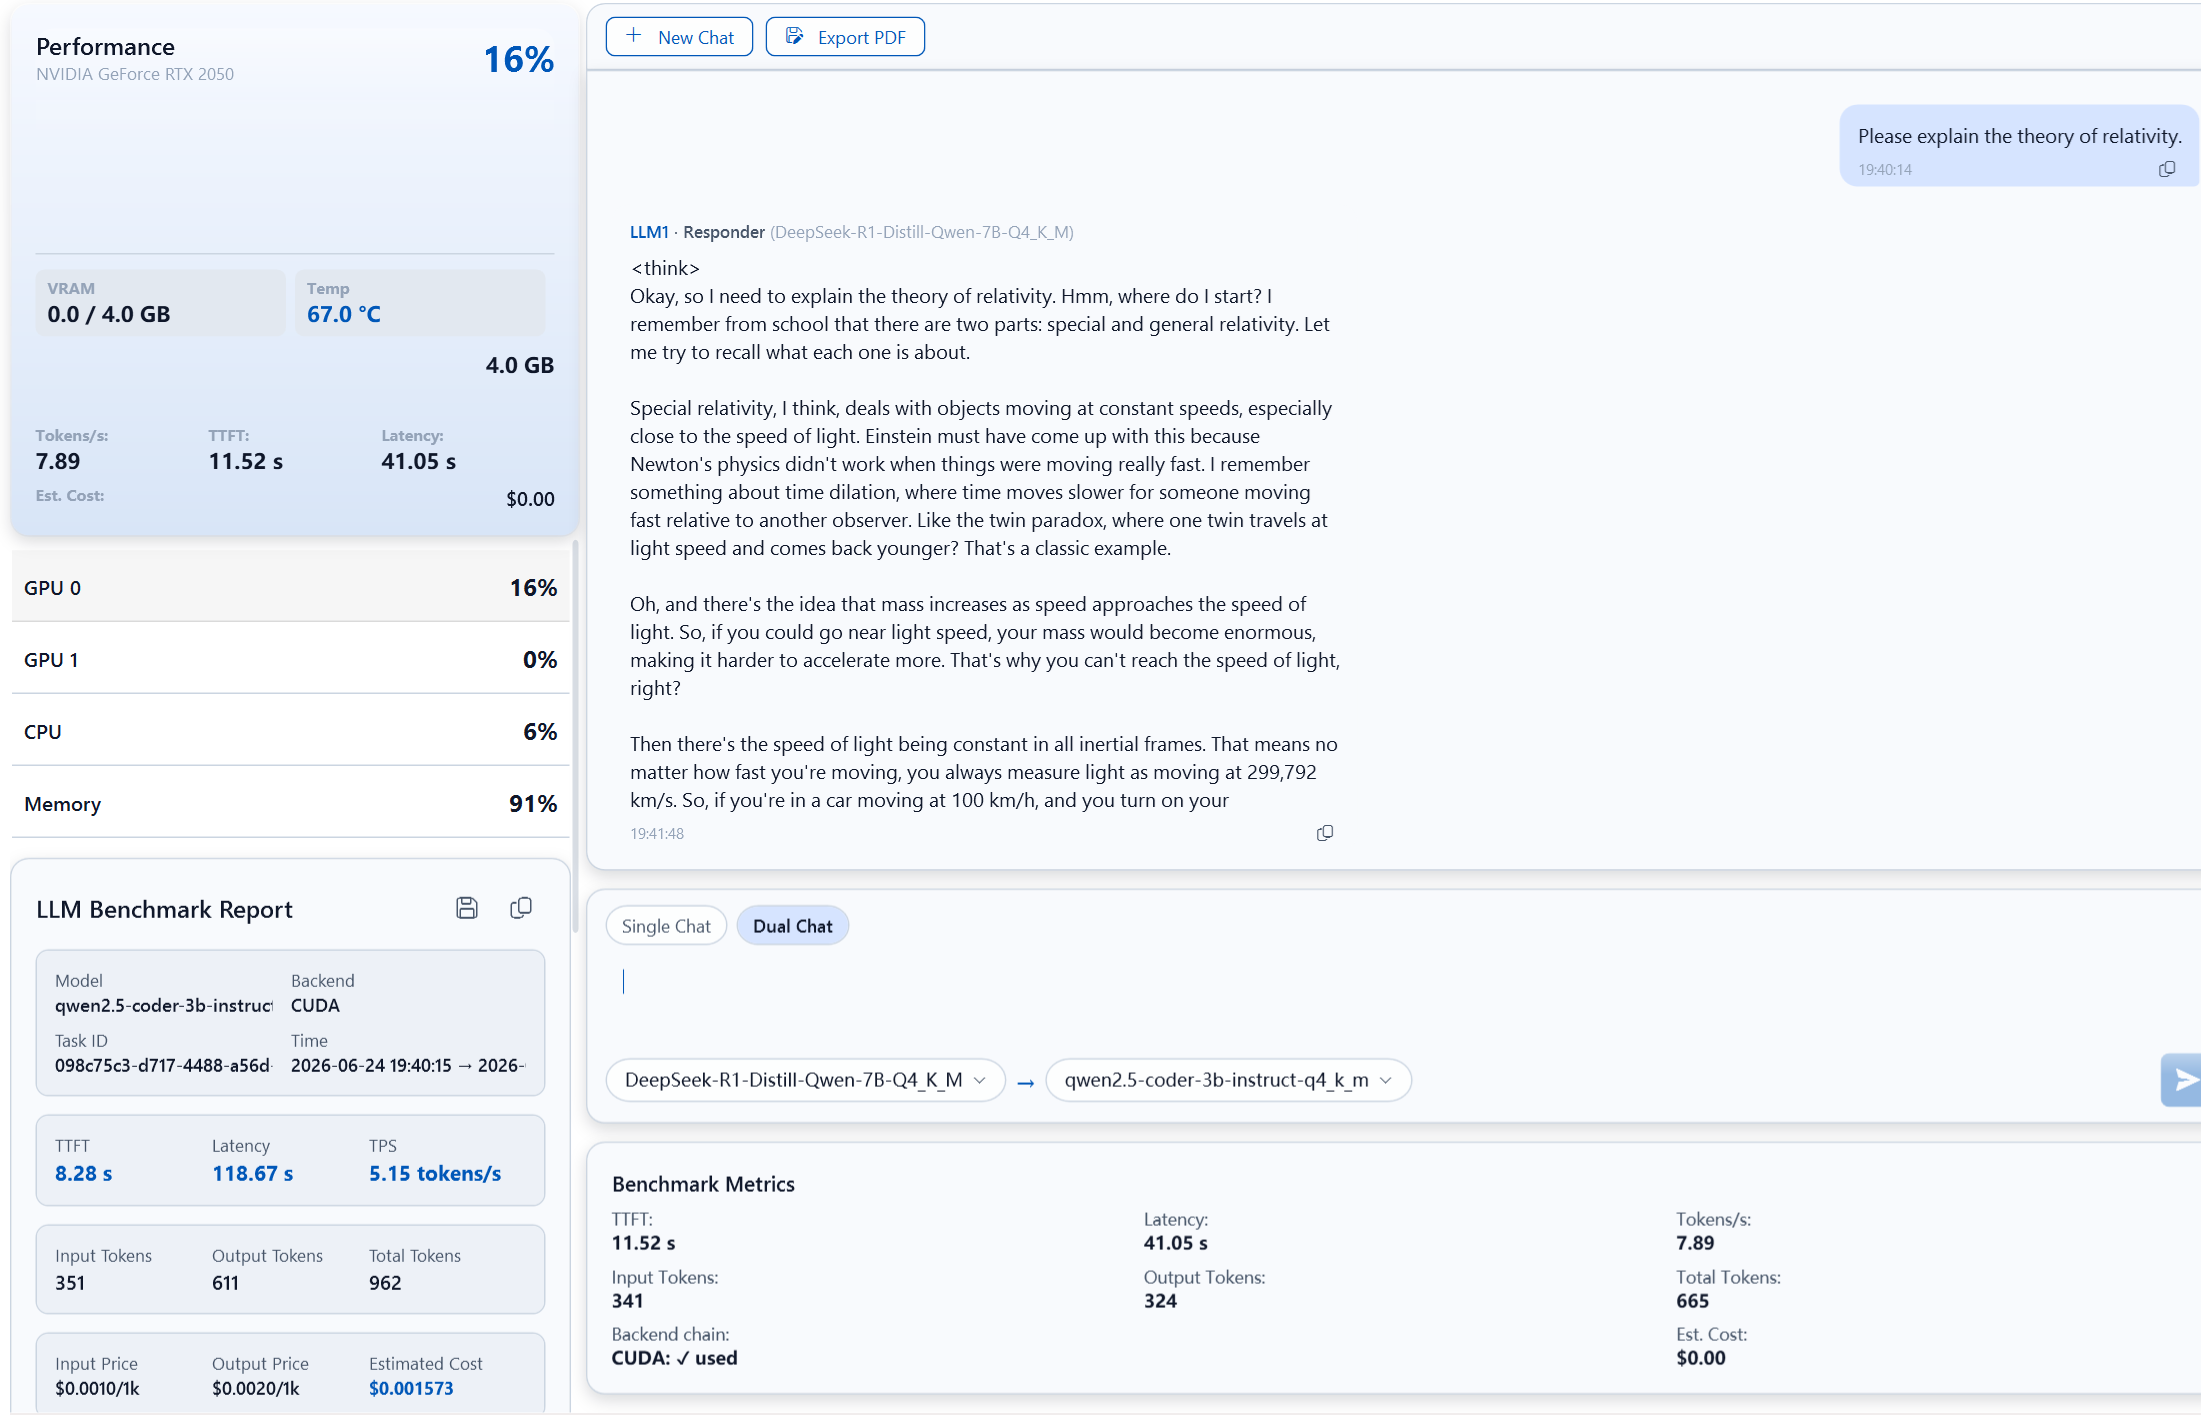
Chat benchmark — chat duplo com monitoramento de GPU e métricas em tempo real
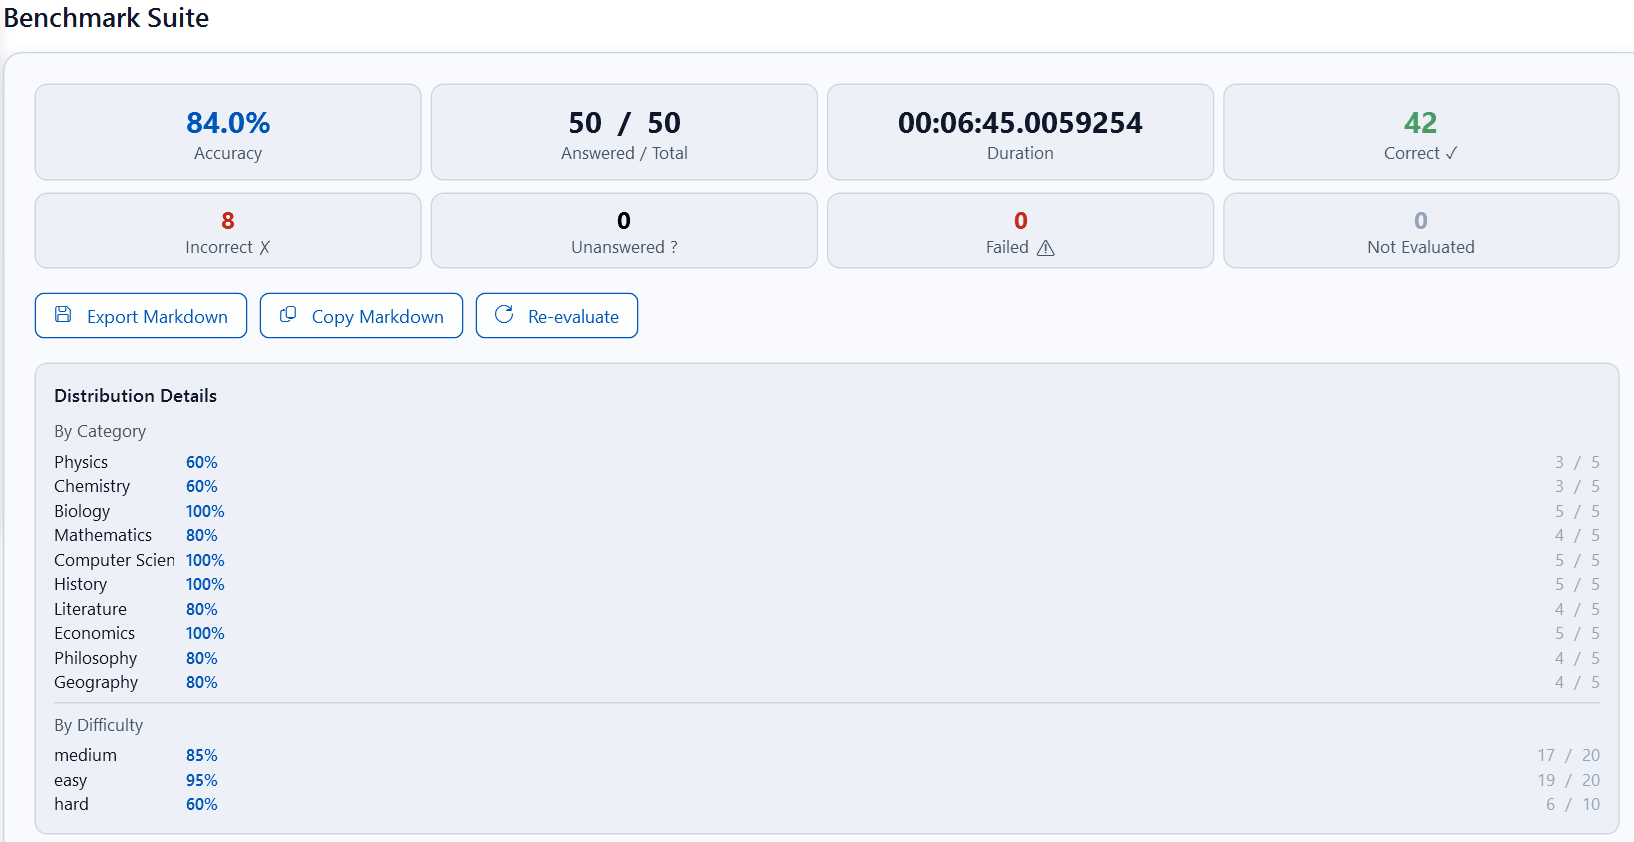
Resultados da bateria de benchmarks — precisão, distribuição por categoria e detalhamento por dificuldade
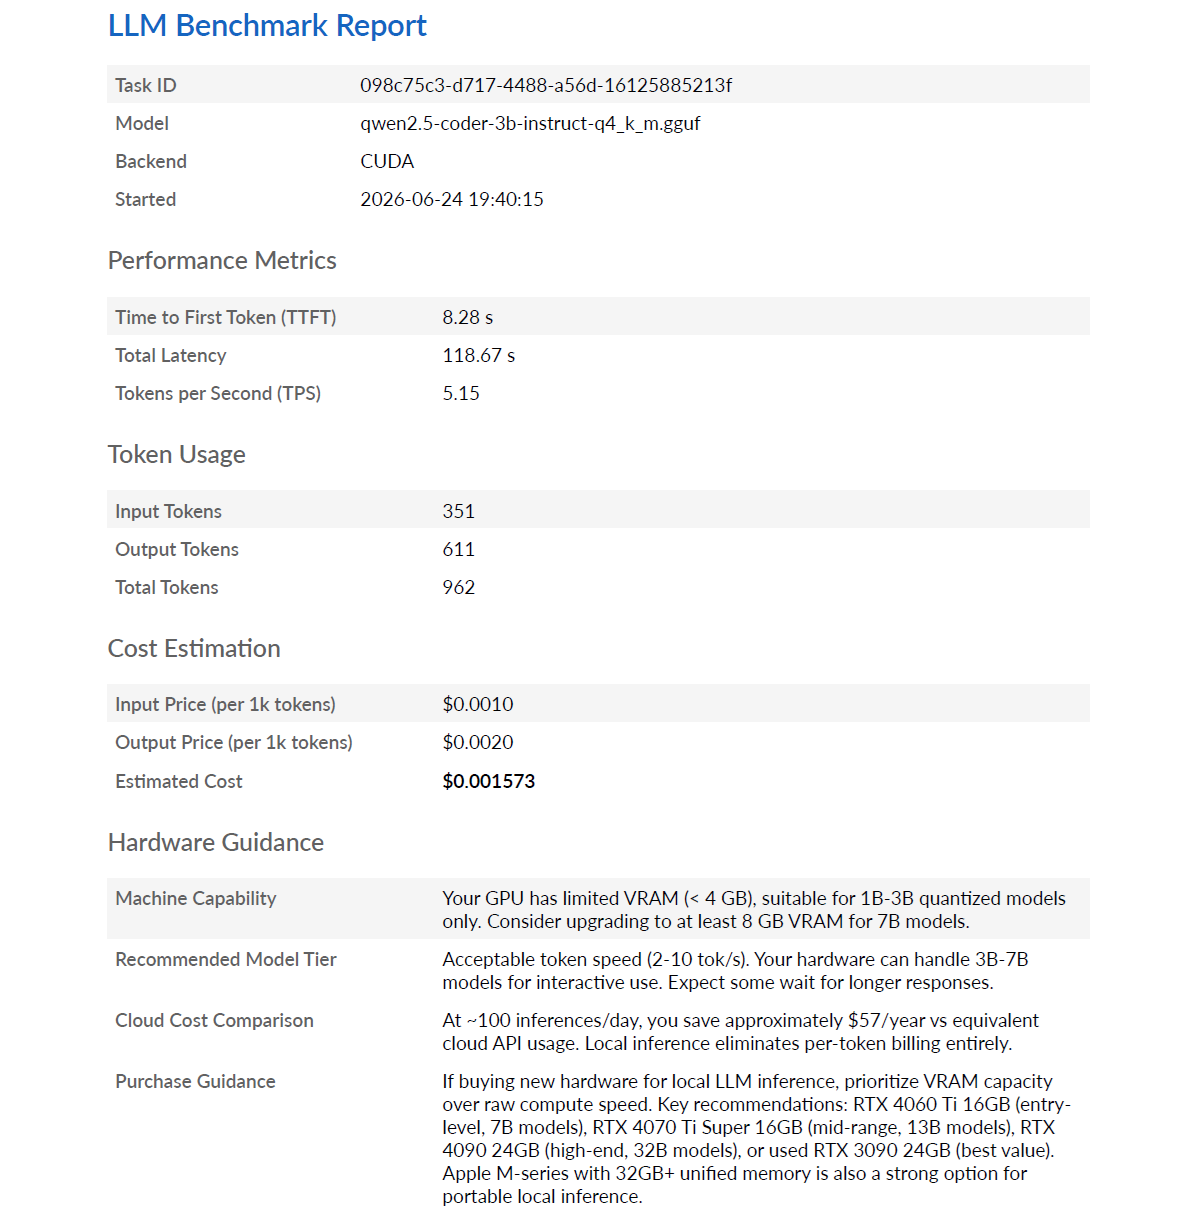
Relatório de benchmark de LLM — métricas de desempenho, estimativa de custo e orientação de hardware

Tudo o que você precisa — e é grátis

O GpuLLM é a suíte grátis mais completa para Windows em avaliação de LLMs locais. Veja tudo o que você recebe — sem assinaturas, sem barreiras de pagamento.

Inferência local de LLM

Execute grandes modelos de linguagem no formato GGUF diretamente na sua GPU, usando o LLamaSharp com o backend llama.cpp. Compatível com CUDA, Vulkan e reserva por CPU — seleciona automaticamente o melhor backend disponível.

Importe modelos GGUF locais

Além do catálogo selecionado, importe qualquer modelo no formato GGUF do seu disco local. Aponte o GpuLLM para seus próprios arquivos GGUF e comece a conversar na hora com modelos personalizados ou da comunidade — sem envio para a nuvem.

Monitoramento de GPU em tempo real

Acompanhe utilização da GPU, uso de VRAM, temperatura e consumo de energia em tempo real. Inclui gráficos de histórico em sparkline de 60 segundos e suporte a várias GPUs com detecção automática de dispositivos.

Chat benchmark e economia de custos

Converse com qualquer modelo e meça na hora a velocidade de geração de tokens da sua GPU (tokens/s), o tempo até o primeiro token e a latência total. O estimador de custo integrado compara sua inferência local com os preços das APIs na nuvem — mostrando exatamente quanto dinheiro você economiza ao executar modelos localmente.

Biblioteca e gerenciador de modelos

Explore 13 modelos selecionados, incluindo Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 e Mistral. Filtre por categoria — programação, chat ou raciocínio — e verifique a compatibilidade com a VRAM com um clique.

Download do HuggingFace

Baixe modelos diretamente do HuggingFace Hub ou do ModelScope. Compatível com downloads retomáveis com verificação SHA-256, reserva entre várias fontes e gerenciamento de consentimento de licença.

Conversa com dois modelos: respondedor e revisor

Inove com um novo padrão de interação — atribua dois papéis de LLM em uma única conversa: um respondedor que responde às suas perguntas e um revisor que avalia e melhora criticamente a resposta. Esse padrão de LLM como juiz / debate agêntico, muito discutido em pesquisas de IA, permite aproveitar ao mesmo tempo os pontos fortes de dois modelos diferentes para conversas de maior qualidade que se autocorrigem.

Animação GPU Spirit

Gato Prisma — um mascote animado ao vivo que reage aos níveis de utilização da sua GPU. Veja o estado emocional e a cor do gato mudarem em tempo real conforme a carga de inferência aumenta.

Avaliação de capacidade dos modelos

Avalie seus modelos com conjuntos abrangentes de perguntas: 100 perguntas em inglês (MMLU, amostradas de 57 disciplinas) e 100 perguntas em chinês (C-Eval), cobrindo mais de 10 dimensões, incluindo matemática, física, química, biologia, ciência da computação, história, literatura, economia, filosofia e geografia. Obtenha precisão por categoria, detalhamento por nível de dificuldade e relatórios em Markdown exportáveis.

Relatório de detalhes da inferência

Cada inferência gera um relatório detalhado com a cadeia de backends, métricas de pico da GPU e estatísticas no nível de token. Exporte conversas completas e relatórios como documentos PDF A4.

O que torna o GpuLLM diferente

GpuLLM

  • ✓Chat e benchmark em uma só interface
  • ✓Conversa com dois modelos (respondedor + revisor)
  • ✓Avaliação de precisão MMLU e C-Eval
  • ✓Monitoramento de GPU em tempo real com gráficos sparkline
  • ✓Estimador de economia frente às APIs na nuvem
  • ✓Catálogo selecionado de 13 modelos, download com um clique
  • ✓100% offline, sem telemetria
  • ✓Totalmente grátis — sem assinaturas

Outras ferramentas

A maioria das alternativas permite conversar com modelos, mas não mede o desempenho, não avalia a precisão nem acompanha as métricas da GPU. Você fica adivinhando qual modelo funciona melhor no seu hardware — e se de fato economiza dinheiro em comparação com as APIs na nuvem.

13 modelos pré-configurados, 3 categorias

Cada entrada inclui o repositório correto do HuggingFace, a quantização e o tamanho do arquivo — baixe com um clique.

Nome exibidoCriadorCategoriaTamanhoVRAM
Qwen2.5-Coder 3BAlibabaCoding1.9 GB8 GB
Qwen2.5-Coder 7BAlibabaCoding4.2 GB16 GB
DeepSeek-Coder V2 LiteDeepSeekCoding9.0 GB24 GB
Llama 3.2 1B InstructMetaChat0.7 GB4 GB
Llama 3.2 3B InstructMetaChat2.0 GB8 GB
Gemma 3 4B InstructGoogleChat2.5 GB8 GB
Mistral 7B InstructMistral AIChat4.1 GB16 GB
Qwen2.5 7B InstructAlibabaChat4.7 GB8 GB
Qwen2.5 14B InstructAlibabaChat8.9 GB24 GB
DeepSeek-R1-Distill 1.5BDeepSeekReasoning1.0 GB4 GB
DeepSeek-R1-Distill 7BDeepSeekReasoning4.2 GB16 GB
DeepSeek-R1-Distill 14BDeepSeekReasoning8.5 GB16 GB
DeepSeek-R1-Distill 32BDeepSeekReasoning20 GB32 GB

100% offline. 100% grátis. Sem letras miúdas.

LLamaSharp / llama.cpp

Motor de inferência C++ de alto desempenho com bindings .NET gerenciados — o mesmo backend que alimenta inúmeras aplicações de IA local no mundo todo.

WPF-UI (Fluent Design)

Interface de desktop moderna para Windows com componentes do Fluent Design System. Suporte a tema claro/escuro com materiais de efeito de vidro e animações suaves.

Reserva entre vários backends

Cadeia automática de reserva CUDA 12 → Vulkan → CPU. O aplicativo detecta o hardware disponível e seleciona o backend mais rápido sem configuração manual.

Privacidade desde a concepção

Toda inferência de modelos, processamento de dados e operações com arquivos acontecem exclusivamente no seu dispositivo local. Sem telemetria, sem dependência da nuvem e sem necessidade de rede depois que os modelos são baixados.

Entendendo o benchmark de LLMs locais

O que são tokens/s?

Tokens por segundo medem a velocidade com que um modelo de linguagem gera texto. Mais tokens/s significa conversas mais ágeis. O GpuLLM mede tanto o pico quanto a taxa sustentada para dar a você uma visão completa do desempenho da sua GPU com LLMs.

O que é TTFT?

O tempo até o primeiro token (TTFT) mede a latência entre enviar um prompt e receber a primeira palavra da resposta. Um TTFT menor significa interações mais rápidas. O GpuLLM monitora o TTFT para ajudar você a comparar a capacidade de resposta dos modelos.

O que é MMLU?

O Massive Multitask Language Understanding (MMLU) é um benchmark padrão que testa conhecimentos em 57 disciplinas. O GpuLLM inclui 100 perguntas amostradas para avaliar a amplitude de conhecimento e a capacidade de raciocínio do seu modelo.

O que é C-Eval?

O C-Eval é um conjunto de avaliação em chinês que abrange 52 disciplinas e quatro níveis de dificuldade. O GpuLLM inclui 100 perguntas para testar a compreensão do chinês e o conhecimento de domínio do seu modelo.

Perguntas frequentes

O GpuLLM é realmente grátis?
Sim. O GpuLLM é totalmente grátis, sem assinaturas, sem barreiras de pagamento e sem custos ocultos. Todos os recursos — chat, benchmark, monitoramento de GPU e avaliação de modelos — estão incluídos sem custo.
O GpuLLM funciona offline?
Sim. Toda a inferência é executada 100% na sua máquina local. A única coisa que acessa a internet é o download dos modelos do HuggingFace ou do ModelScope. Depois de baixados, não é necessária conexão com a internet.
Quais modelos posso executar com o GpuLLM?
O GpuLLM é compatível com todos os modelos no formato GGUF. Ele vem com um catálogo selecionado de 13 modelos, incluindo Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 e Mistral. Você também pode importar qualquer arquivo GGUF do seu disco local.
Em que o GpuLLM é diferente de outras ferramentas de LLM?
A maioria das alternativas permite conversar com modelos, mas não mede o desempenho, não avalia a precisão nem acompanha as métricas da GPU. O GpuLLM é o único aplicativo grátis para Windows que combina chat, benchmark, monitoramento de GPU, avaliação de modelos (MMLU/C-Eval) e estimativa de custo em um só pacote.
Como começar a usar o GpuLLM?
Baixe o GpuLLM na Microsoft Store, explore a biblioteca de modelos para escolher um que caiba na VRAM da sua GPU, clique em Baixar, depois em Carregar, e comece a conversar no Chat benchmark. Há um guia completo na seção de ajuda.

O GpuLLM é um aplicativo de desktop para Windows. Toda inferência, benchmark e avaliação são executados localmente no seu dispositivo. Nenhum dado de modelo ou conteúdo de conversa é enviado a qualquer servidor. O link de download abre a Microsoft Store no seu navegador padrão.

All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.