Приложение для Windows

Самый полный способ оценить скорость и возможности локальных LLM

GpuLLM — бесплатное приложение для Windows для всесторонней оценки локальных LLM: измеряет и скорость инференса (токены/с, задержку), и возможности модели (точность MMLU, C-Eval). Все полностью офлайн — чат, бенчмарки, мониторинг GPU, управление моделями; единственное, что выходит в интернет — загрузка моделей. Найдите идеальное соответствие модели и железа за минуты, а не часы. Без облачной зависимости, без API-ключей, данные не покидают машину.

Windows 10 / 11100% Offline11 LanguagesCUDA / Vulkan / CPU

Смотрите сами

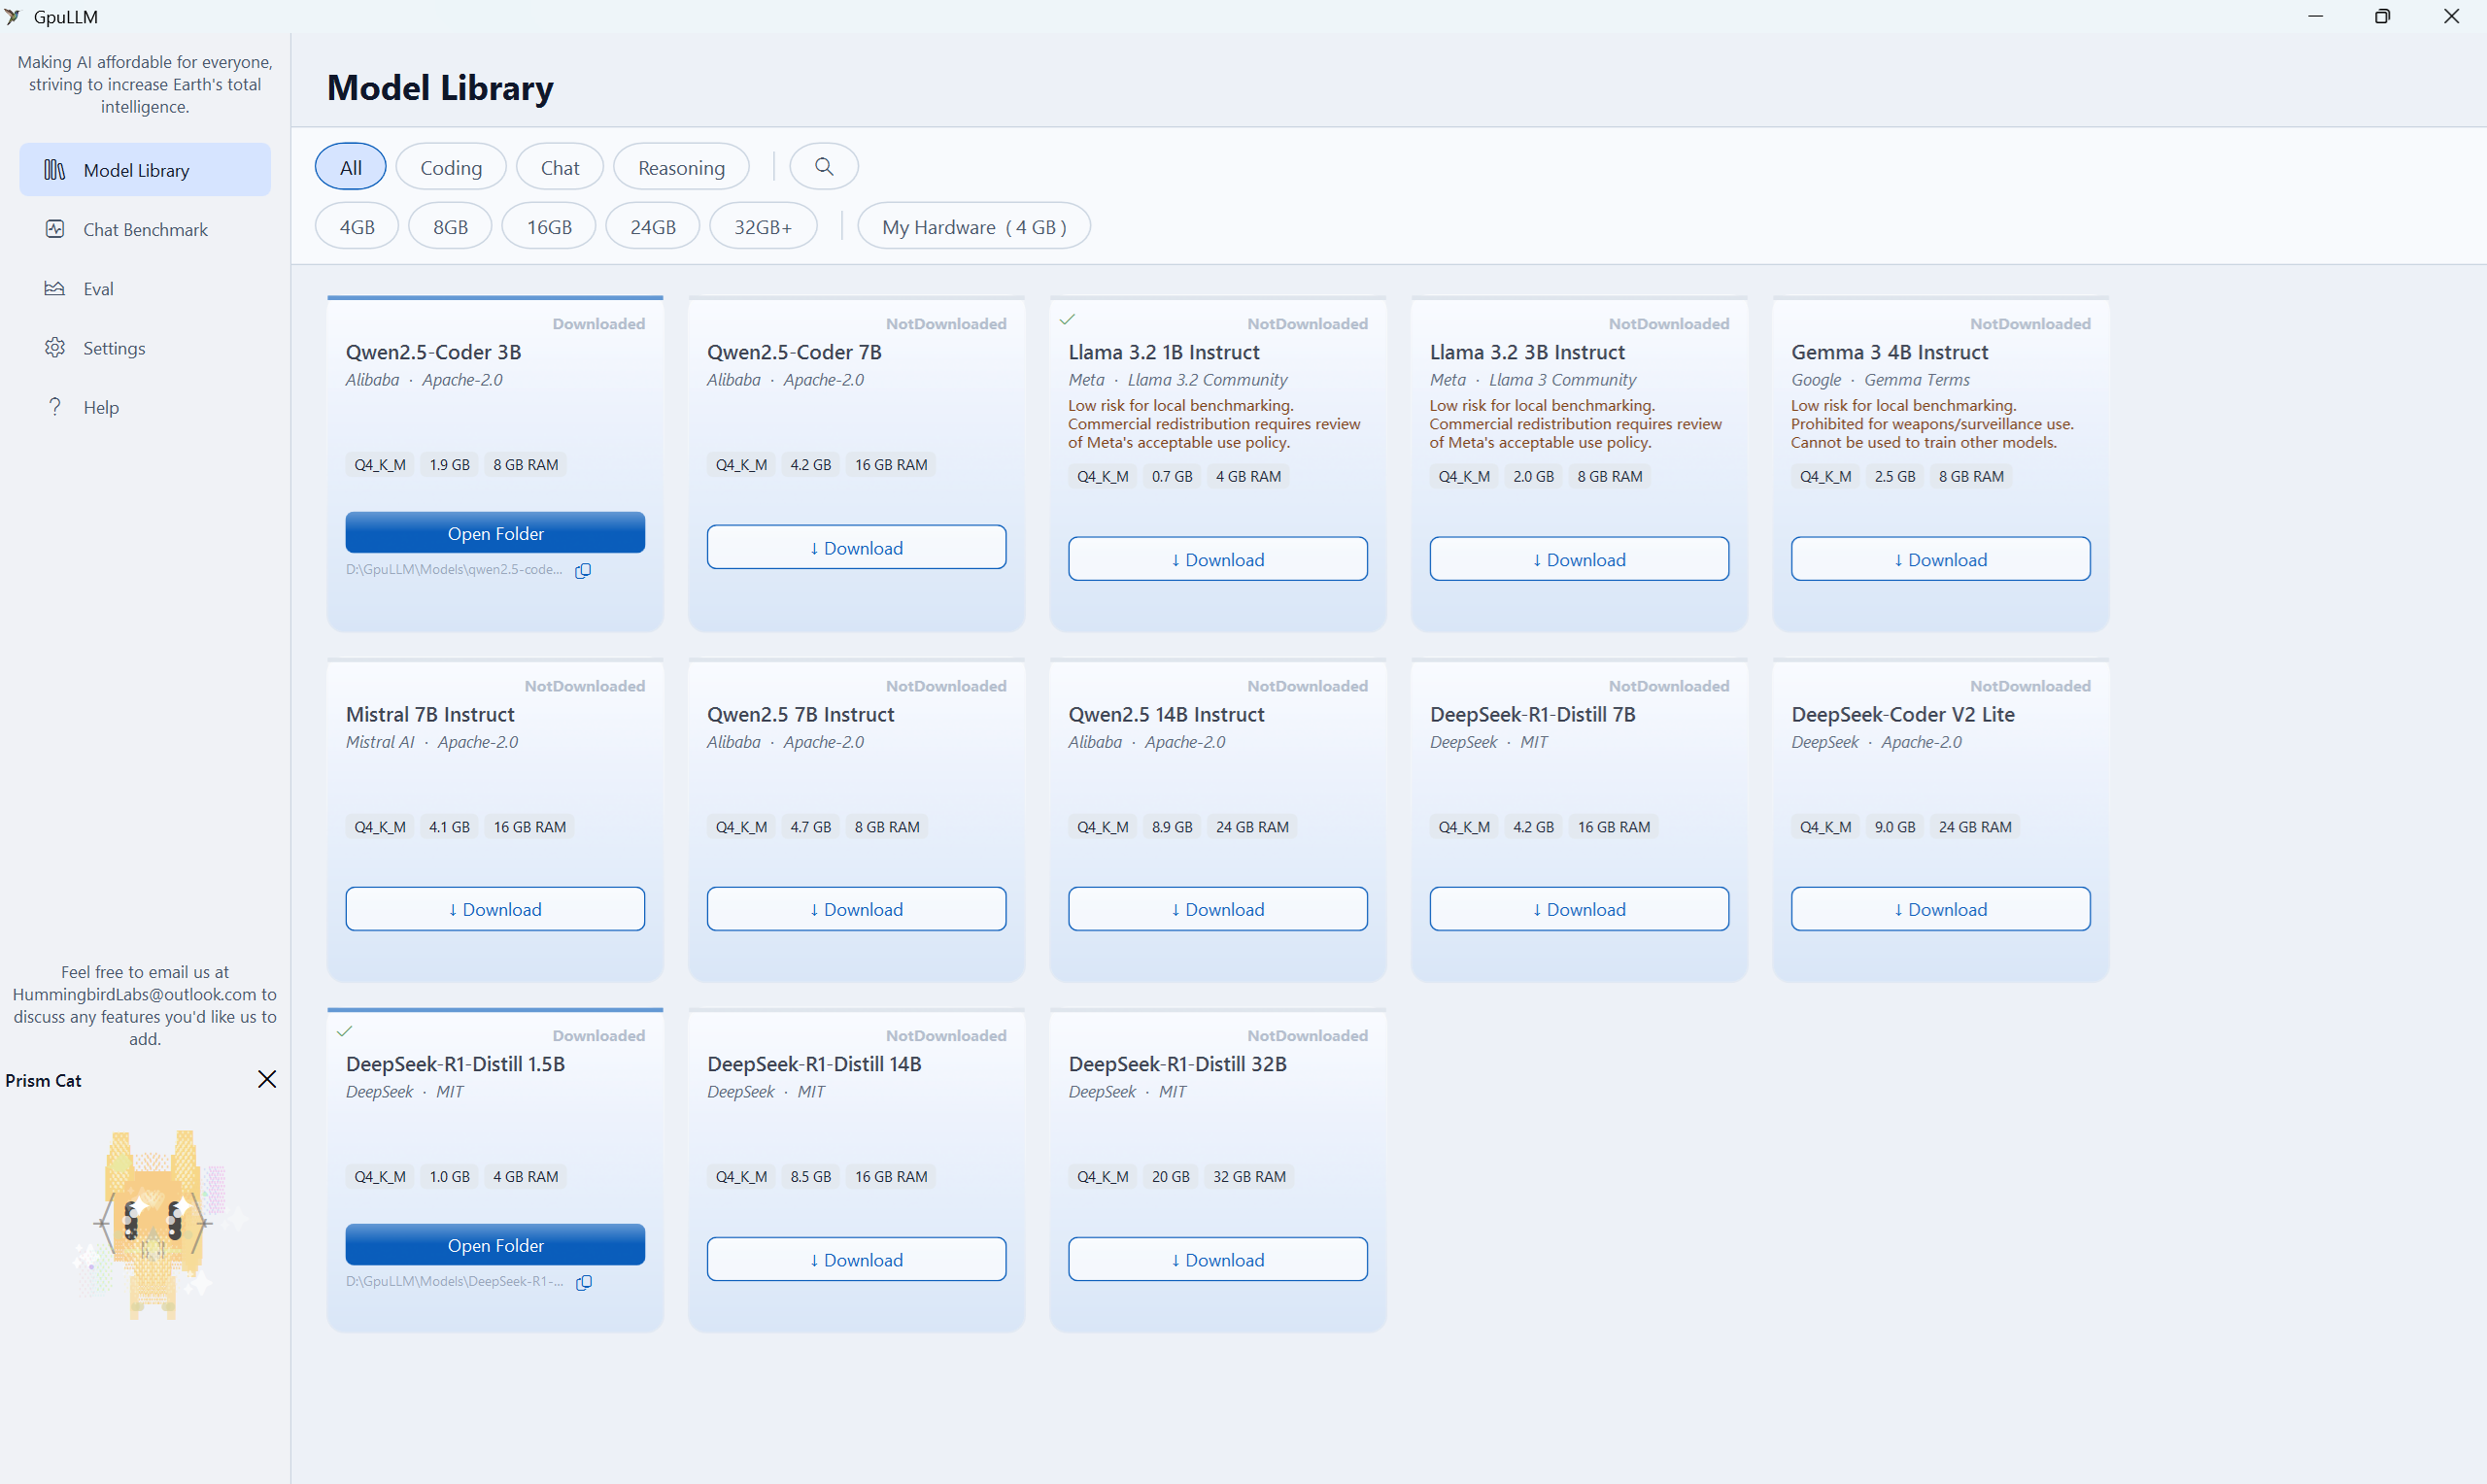
Библиотека моделей — поиск, фильтры и загрузка отобранных LLM
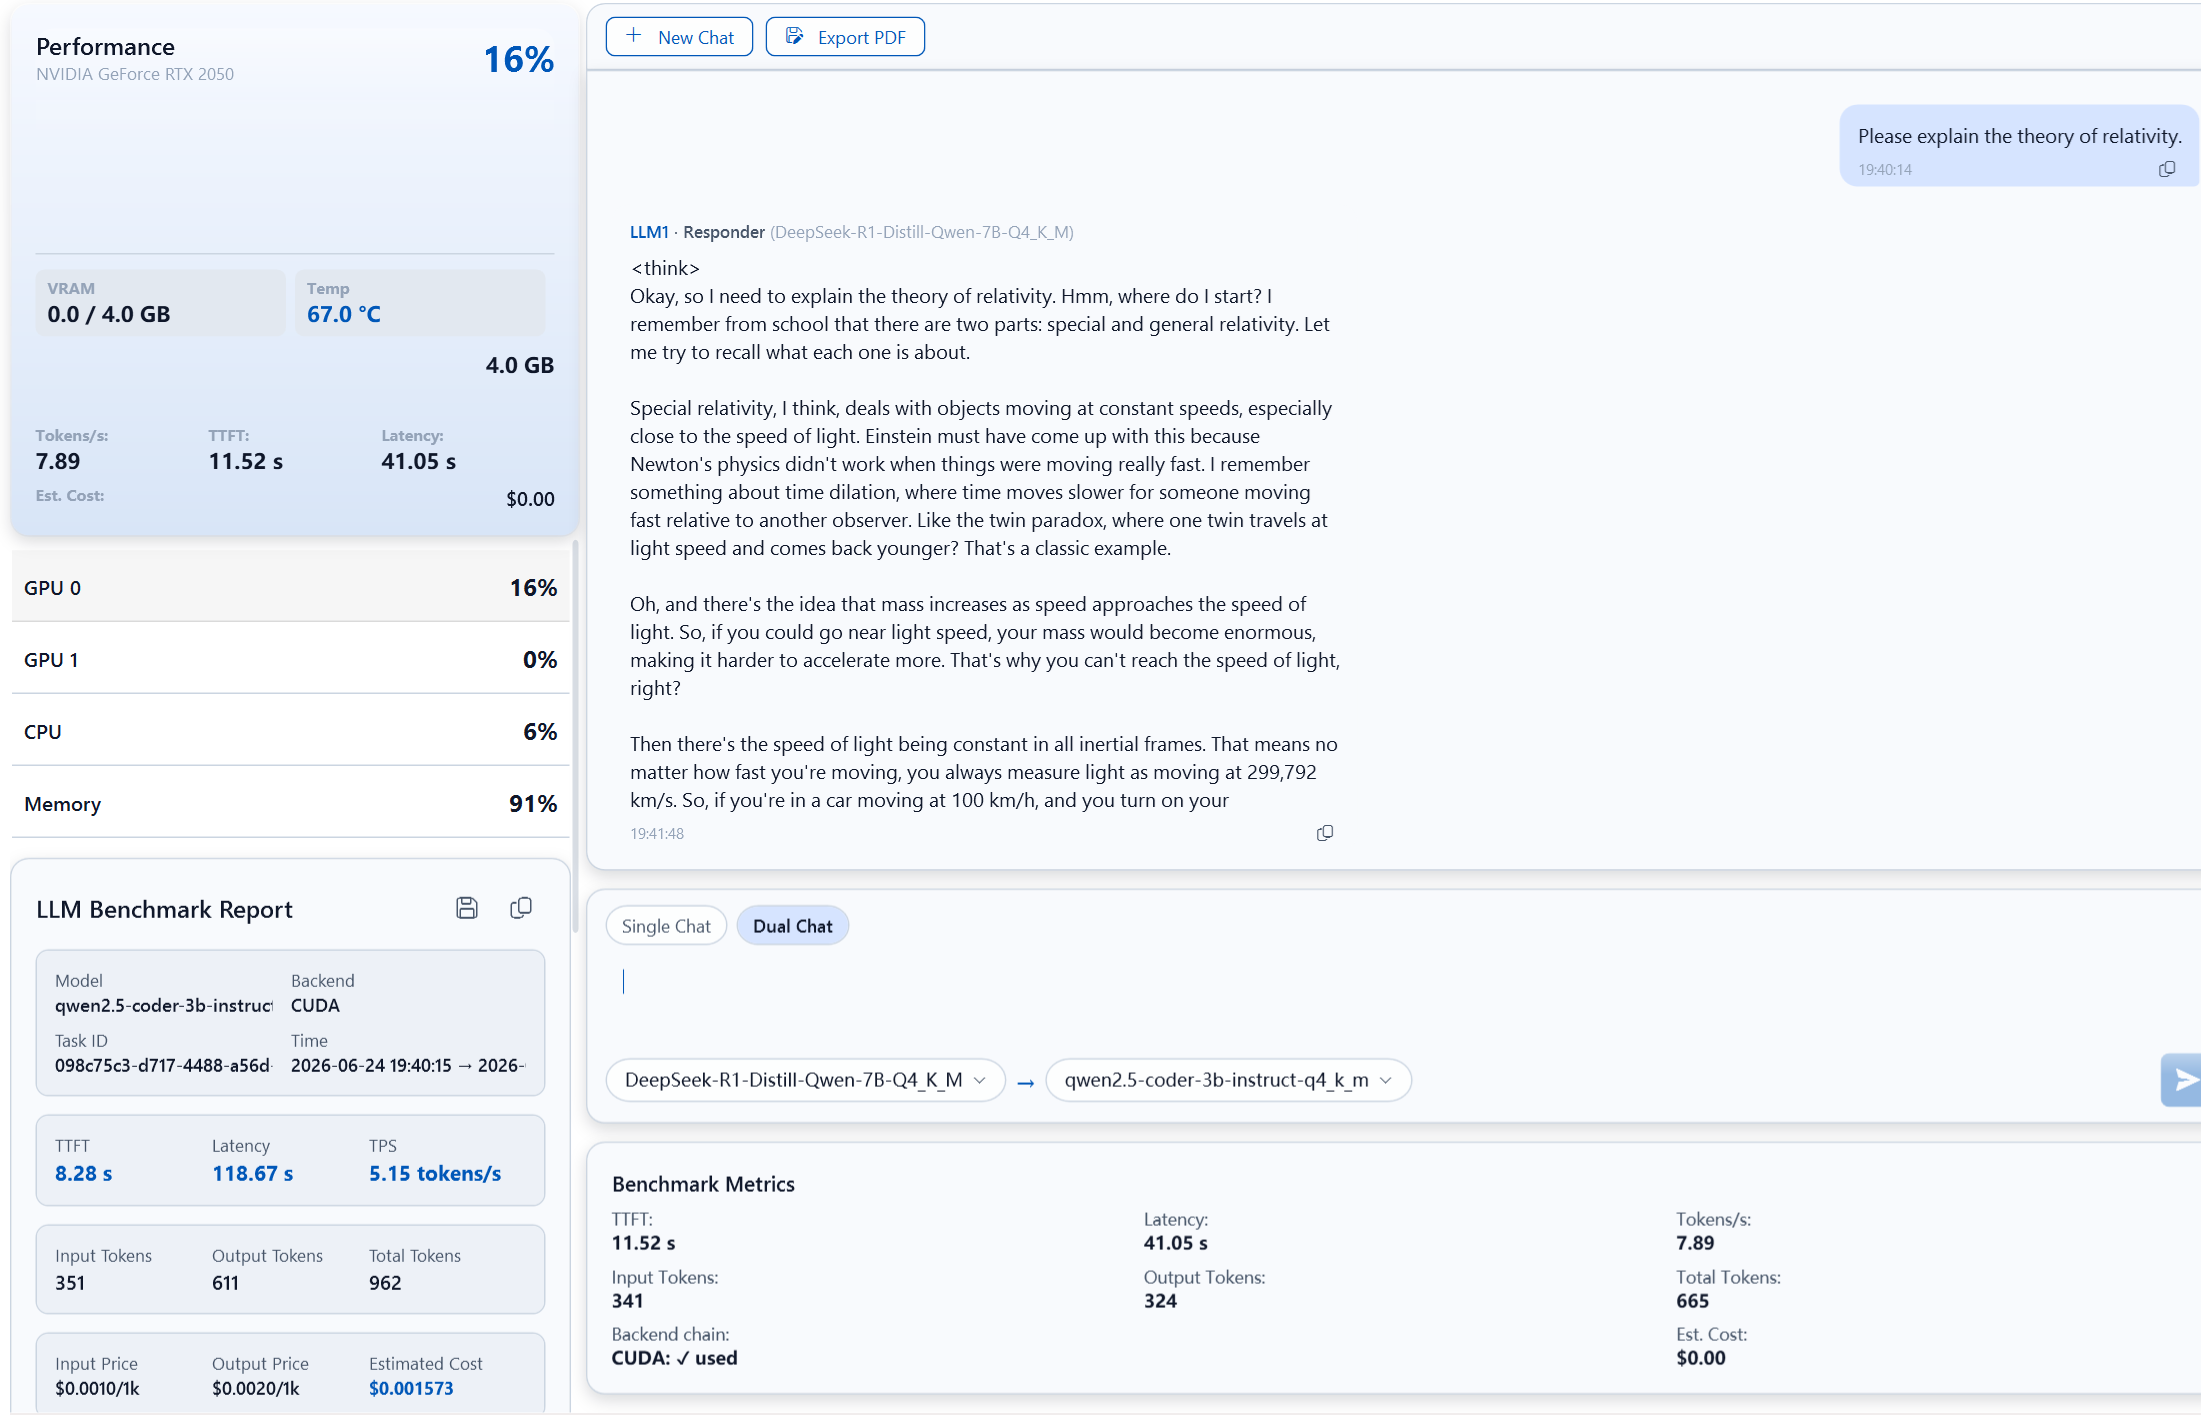
Чат-бенчмарк — двойной чат с мониторингом GPU и метриками в реальном времени
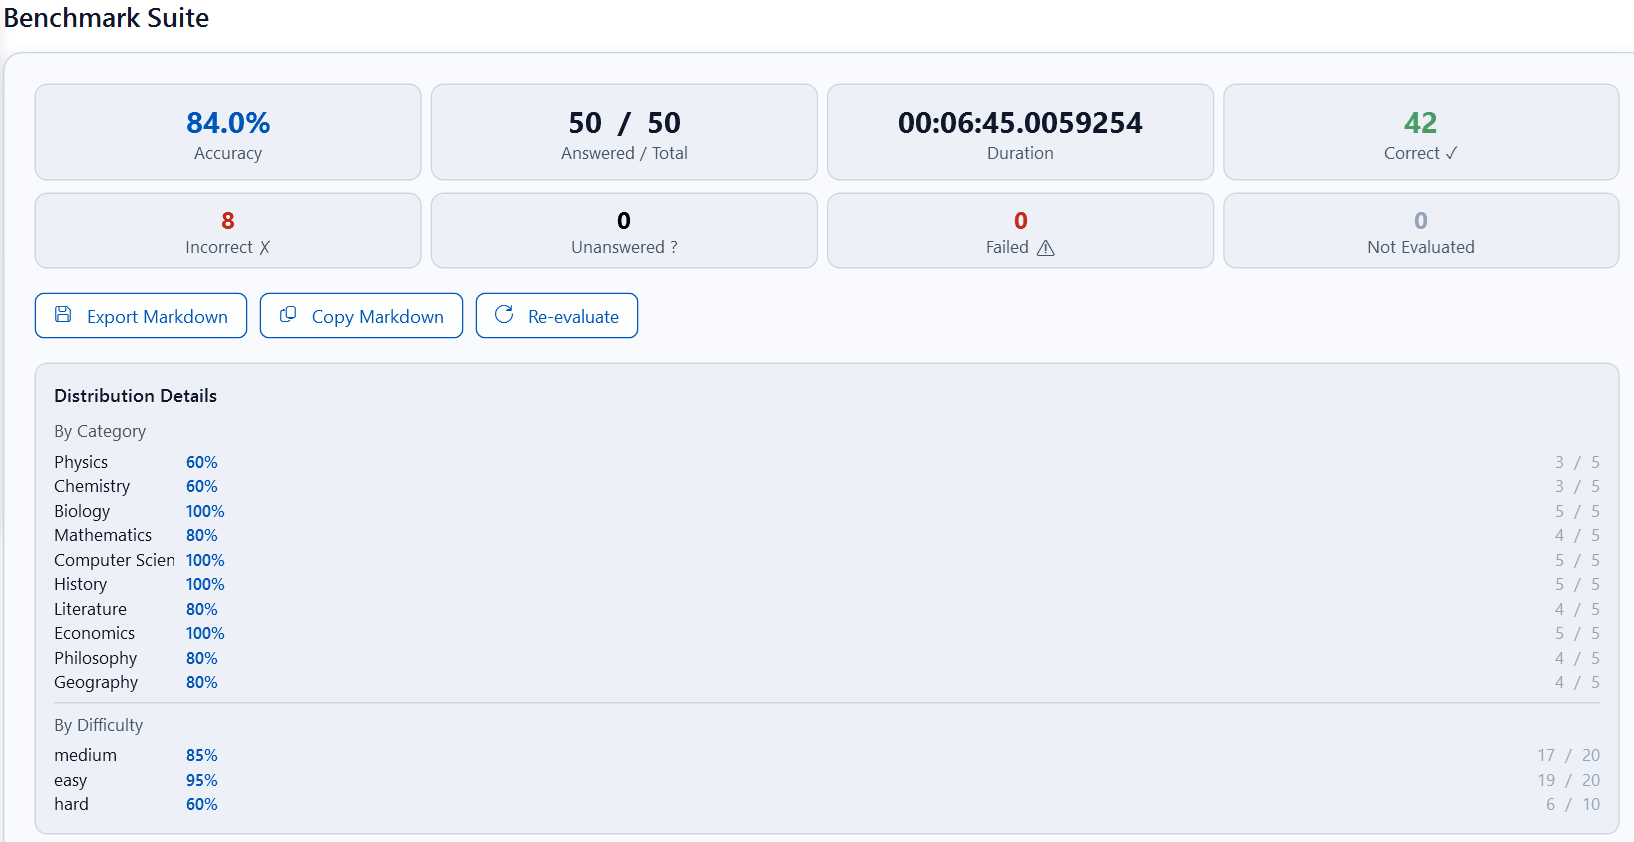
Результаты набора бенчмарков — точность, распределение по категориям и разбивка по сложности
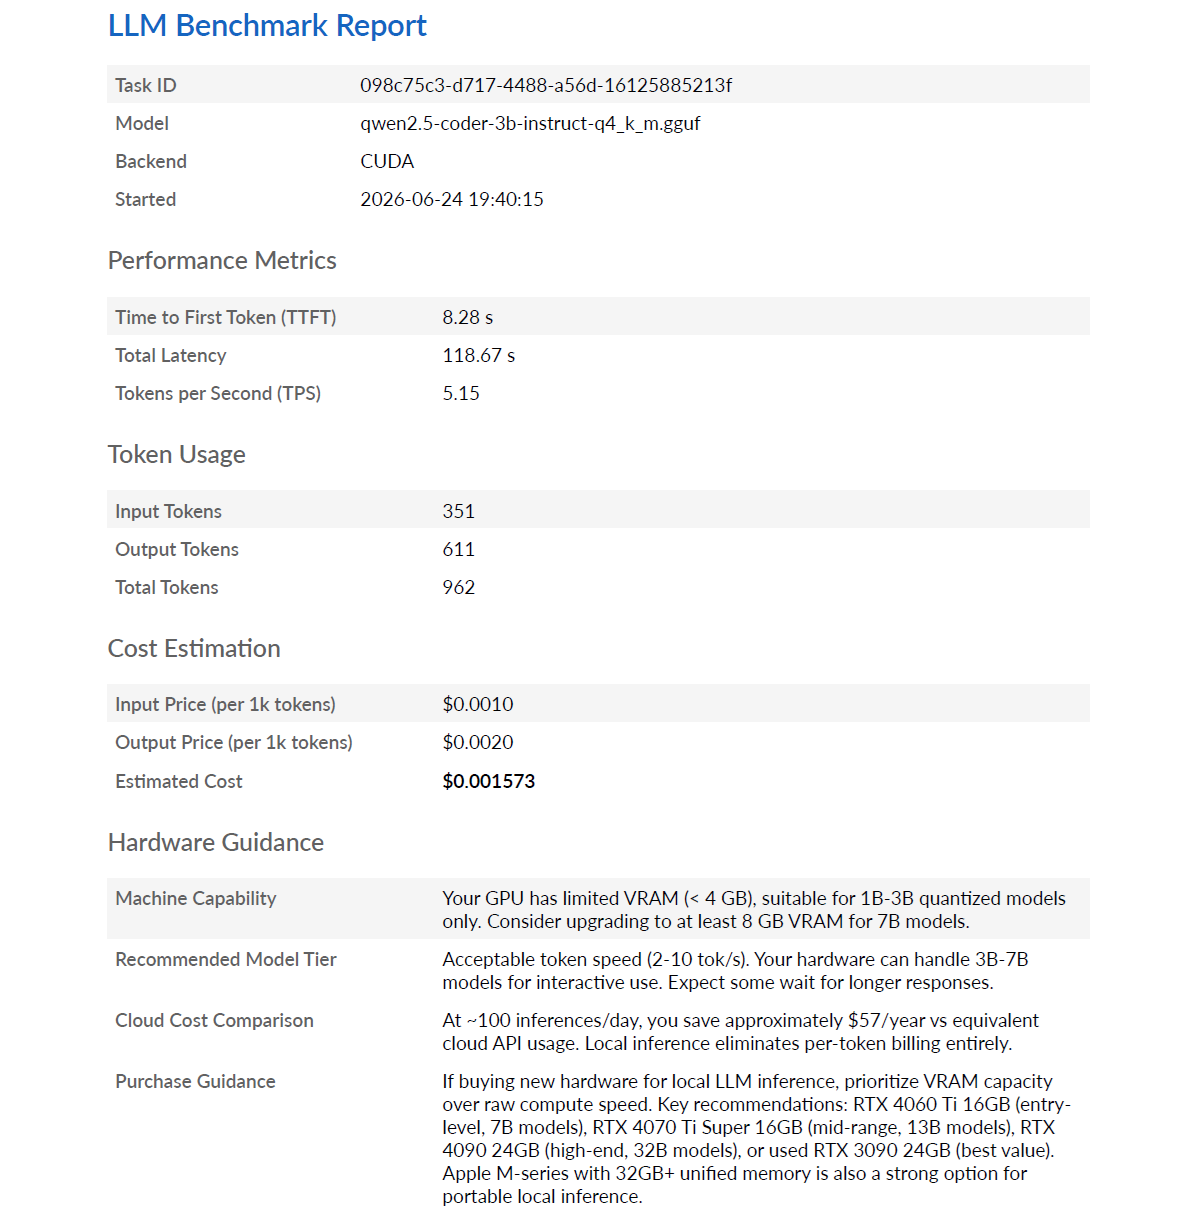
Отчет бенчмарка LLM — метрики производительности, оценка расходов и рекомендации по железу

Все, что нужно, — и это бесплатно

GpuLLM — самый полный бесплатный набор для Windows для оценки локальных LLM. Вот все, что вы получаете: без подписок и платных стен.

Локальный инференс LLM

Запускайте большие языковые модели в формате GGUF прямо на GPU через LLamaSharp с бэкендом llama.cpp. Поддерживаются CUDA, Vulkan и запасной режим на CPU — лучший доступный бэкенд выбирается автоматически.

Импорт локальных GGUF-моделей

Помимо готового каталога, импортируйте любую модель в формате GGUF с локального диска. Укажите GpuLLM свои GGUF-файлы и сразу общайтесь с собственными моделями или моделями сообщества — без загрузки в облако.

Мониторинг GPU в реальном времени

Отслеживайте загрузку GPU, использование VRAM, температуру и энергопотребление в реальном времени. Есть 60-секундные спарклайны и поддержка нескольких GPU с автоматическим обнаружением устройств.

Чат-бенчмарк и экономия расходов

Общайтесь с любой моделью и мгновенно измеряйте скорость генерации токенов на GPU (токены/с), время до первого токена и суммарную задержку. Встроенный расчет расходов сравнивает локальный инференс с ценами облачных API и точно показывает, сколько денег вы экономите, запуская модели локально.

Библиотека и менеджер моделей

13 отобранных моделей, включая Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 и Mistral. Фильтруйте по категориям — программирование, чат или рассуждения — и в один клик проверяйте совместимость с объемом VRAM.

Загрузка с HuggingFace

Скачивайте модели напрямую с HuggingFace Hub или ModelScope. Поддерживаются докачка, проверка SHA-256, переключение источников и управление согласием с лицензиями.

Диалог двух моделей: отвечающий и проверяющий

Новый формат взаимодействия: назначьте двум LLM роли в одном чате — отвечающий дает ответы на вопросы, а проверяющий критически оценивает и улучшает их. Паттерн «LLM-судья» и агентских дебатов, обсуждаемый в исследованиях ИИ, позволяет использовать сильные стороны двух моделей одновременно ради более качественного самокорректирующегося диалога.

Анимация духа GPU

Кот-Призма — живой анимированный маскот, реагирующий на уровень загрузки GPU. Наблюдайте, как его настроение и цвет меняются в реальном времени по мере роста нагрузки инференса.

Оценка возможностей модели

Прогоняйте модели по подробным наборам вопросов: 100 английских (MMLU, выборка из 57 дисциплин) и 100 китайских (C-Eval), охватывающих 10+ направлений, включая математику, физику, химию, биологию, информатику, историю, литературу, экономику, философию и географию. Точность по категориям, разбивка по уровню сложности и экспорт отчетов в Markdown.

Отчет по инференсу

Каждый инференс дает подробный отчет с цепочкой бэкендов, пиковыми метриками GPU и статистикой на уровне токенов. Полные диалоги и отчеты экспортируются в PDF формата A4.

Чем GpuLLM отличается

GpuLLM

  • ✓Чат и бенчмарк в одном интерфейсе
  • ✓Диалог двух моделей (отвечающий и проверяющий)
  • ✓Оценка точности MMLU и C-Eval
  • ✓Мониторинг GPU в реальном времени со спарклайнами
  • ✓Расчет экономии против облачных API
  • ✓Каталог из 13 моделей, загрузка в один клик
  • ✓Полностью офлайн, без телеметрии
  • ✓Совершенно бесплатно — без подписок

Другие инструменты

Большинство альтернатив позволяет общаться с моделями, но не измеряет производительность, не оценивает точность и не следит за метриками GPU. Приходится гадать, какая модель лучше работает на вашем железе и действительно ли вы экономите по сравнению с облачными API.

13 преднастроенных моделей, 3 категории

Для каждой модели уже заданы репозиторий HuggingFace, квантизация и размер файла — загрузка в один клик.

НазваниеСоздательКатегорияРазмерVRAM
Qwen2.5-Coder 3BAlibabaCoding1.9 GB8 GB
Qwen2.5-Coder 7BAlibabaCoding4.2 GB16 GB
DeepSeek-Coder V2 LiteDeepSeekCoding9.0 GB24 GB
Llama 3.2 1B InstructMetaChat0.7 GB4 GB
Llama 3.2 3B InstructMetaChat2.0 GB8 GB
Gemma 3 4B InstructGoogleChat2.5 GB8 GB
Mistral 7B InstructMistral AIChat4.1 GB16 GB
Qwen2.5 7B InstructAlibabaChat4.7 GB8 GB
Qwen2.5 14B InstructAlibabaChat8.9 GB24 GB
DeepSeek-R1-Distill 1.5BDeepSeekReasoning1.0 GB4 GB
DeepSeek-R1-Distill 7BDeepSeekReasoning4.2 GB16 GB
DeepSeek-R1-Distill 14BDeepSeekReasoning8.5 GB16 GB
DeepSeek-R1-Distill 32BDeepSeekReasoning20 GB32 GB

Полностью офлайн. Полностью бесплатно. Без оговорок.

LLamaSharp / llama.cpp

Высокопроизводительный C++ движок инференса с управляемыми биндингами .NET — тот же бэкенд, что лежит в основе бесчисленных локальных ИИ-приложений по всему миру.

WPF-UI (Fluent Design)

Современный интерфейс рабочего стола Windows на компонентах Fluent Design System. Темная и светлая темы, стеклянные материалы и плавные анимации.

Выбор бэкенда с запасным вариантом

Автоматическая цепочка CUDA 12 → Vulkan → CPU. Приложение обнаруживает доступное железо и выбирает самый быстрый бэкенд без ручной настройки.

Приватность по умолчанию

Весь инференс, обработка данных и файловые операции выполняются исключительно на локальном устройстве. Никакой телеметрии и облачной зависимости; после загрузки моделей сеть не нужна.

Разбираемся в бенчмарках локальных LLM

Что такое токены/с?

Число токенов в секунду показывает, насколько быстро языковая модель генерирует текст. Чем выше токенов/с, тем отзывчивее диалог. GpuLLM измеряет и пиковую, и устойчивую пропускную способность, давая полную картину производительности вашего GPU в LLM.

Что такое TTFT?

Время до первого токена (TTFT) измеряет задержку между отправкой запроса и получением первого слова ответа. Чем ниже TTFT, тем живее взаимодействие. GpuLLM отслеживает TTFT, чтобы помогать сравнивать отзывчивость моделей.

Что такое MMLU?

Massive Multitask Language Understanding (MMLU) — стандартный бенчмарк знаний по 57 дисциплинам. В GpuLLM включена выборка из 100 вопросов для оценки широты знаний и способности модели к рассуждениям.

Что такое C-Eval?

C-Eval — китайский набор для оценки по 52 дисциплинам и четырем уровням сложности. В GpuLLM включены 100 вопросов для проверки понимания китайского языка и предметных знаний модели.

Частые вопросы

GpuLLM действительно бесплатный?
Да. GpuLLM полностью бесплатен: без подписок, платных стен и скрытых расходов. Все функции — чат, бенчмарк, мониторинг GPU и оценка моделей — включены без дополнительной платы.
GpuLLM работает офлайн?
Да. Весь инференс выполняется на 100% локально на вашей машине. Единственное, что выходит в интернет — загрузка моделей с HuggingFace или ModelScope. После загрузки подключение к интернету не требуется.
Какие модели можно запускать в GpuLLM?
GpuLLM поддерживает все модели в формате GGUF. В комплект входит отобранный каталог из 13 моделей, включая Qwen2.5-Coder, DeepSeek-R1, Llama 3.2, Gemma 3 и Mistral. Также можно импортировать любой GGUF-файл с локального диска.
Чем GpuLLM отличается от других LLM-инструментов?
Большинство альтернатив позволяет общаться с моделями, но не измеряет производительность, не оценивает точность и не следит за метриками GPU. GpuLLM — единственное бесплатное приложение для Windows, объединяющее чат, бенчмарк, мониторинг GPU, оценку моделей (MMLU/C-Eval) и расчет расходов в одном пакете.
Как начать работать с GpuLLM?
Скачайте GpuLLM из Microsoft Store, в библиотеке моделей выберите модель под объем VRAM вашего GPU, нажмите «Скачать», затем «Загрузить» и начинайте диалог в чат-бенчмарке. Полное руководство есть в разделе справки.

GpuLLM — приложение для Windows. Все инференсы, бенчмарки и оценки выполняются локально на вашем устройстве. Данные моделей и содержимое чатов никогда не загружаются на серверы. Ссылка для скачивания открывает Microsoft Store в браузере по умолчанию.

All tools on fastool.io run entirely in your browser — zero data leaves your device. No personal data is collected, stored, or transmitted to any server. Solar calculations use SunCalc.js; lunar data uses JPL DE440 ephemeris; coordinate transforms use publicly documented EPSG/OGC standards. This site requires no signup, no account, and no cloud processing.